
多模态大模型进工厂:看得见的收益,看不见的坑
一、工厂里真正缺的不是数据,是理解
1、数据很多,能被用起来的很少
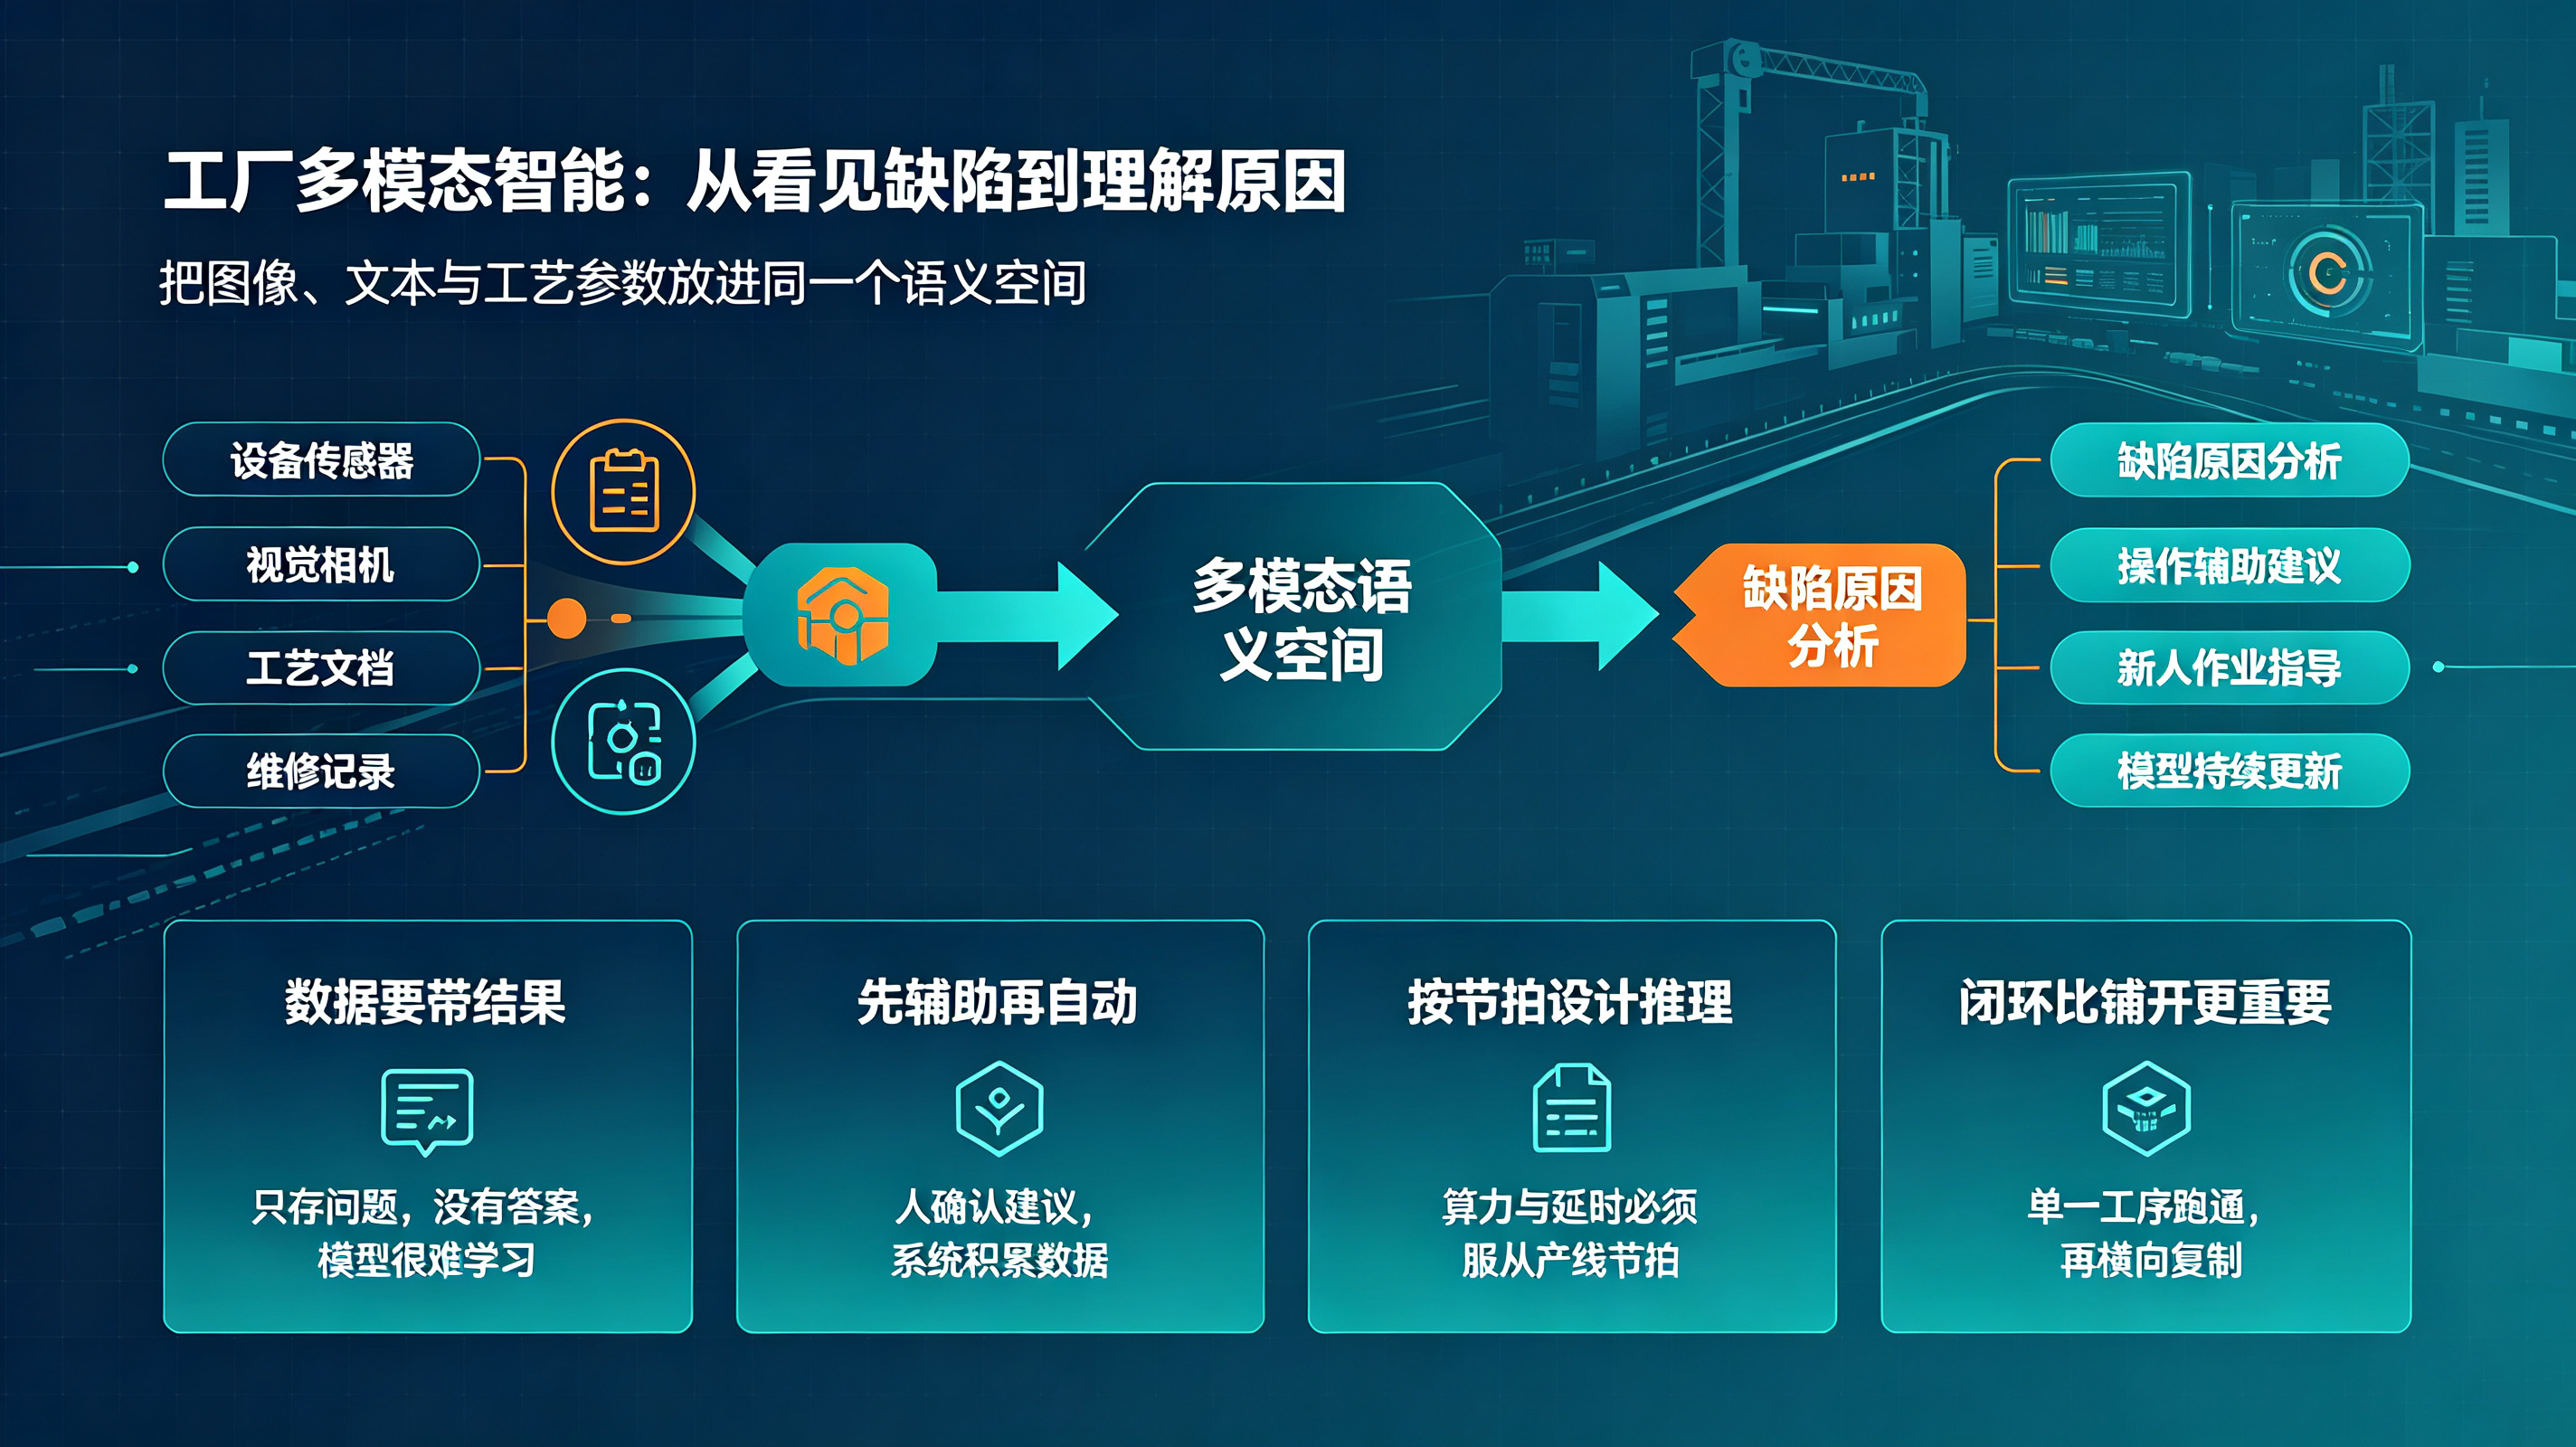
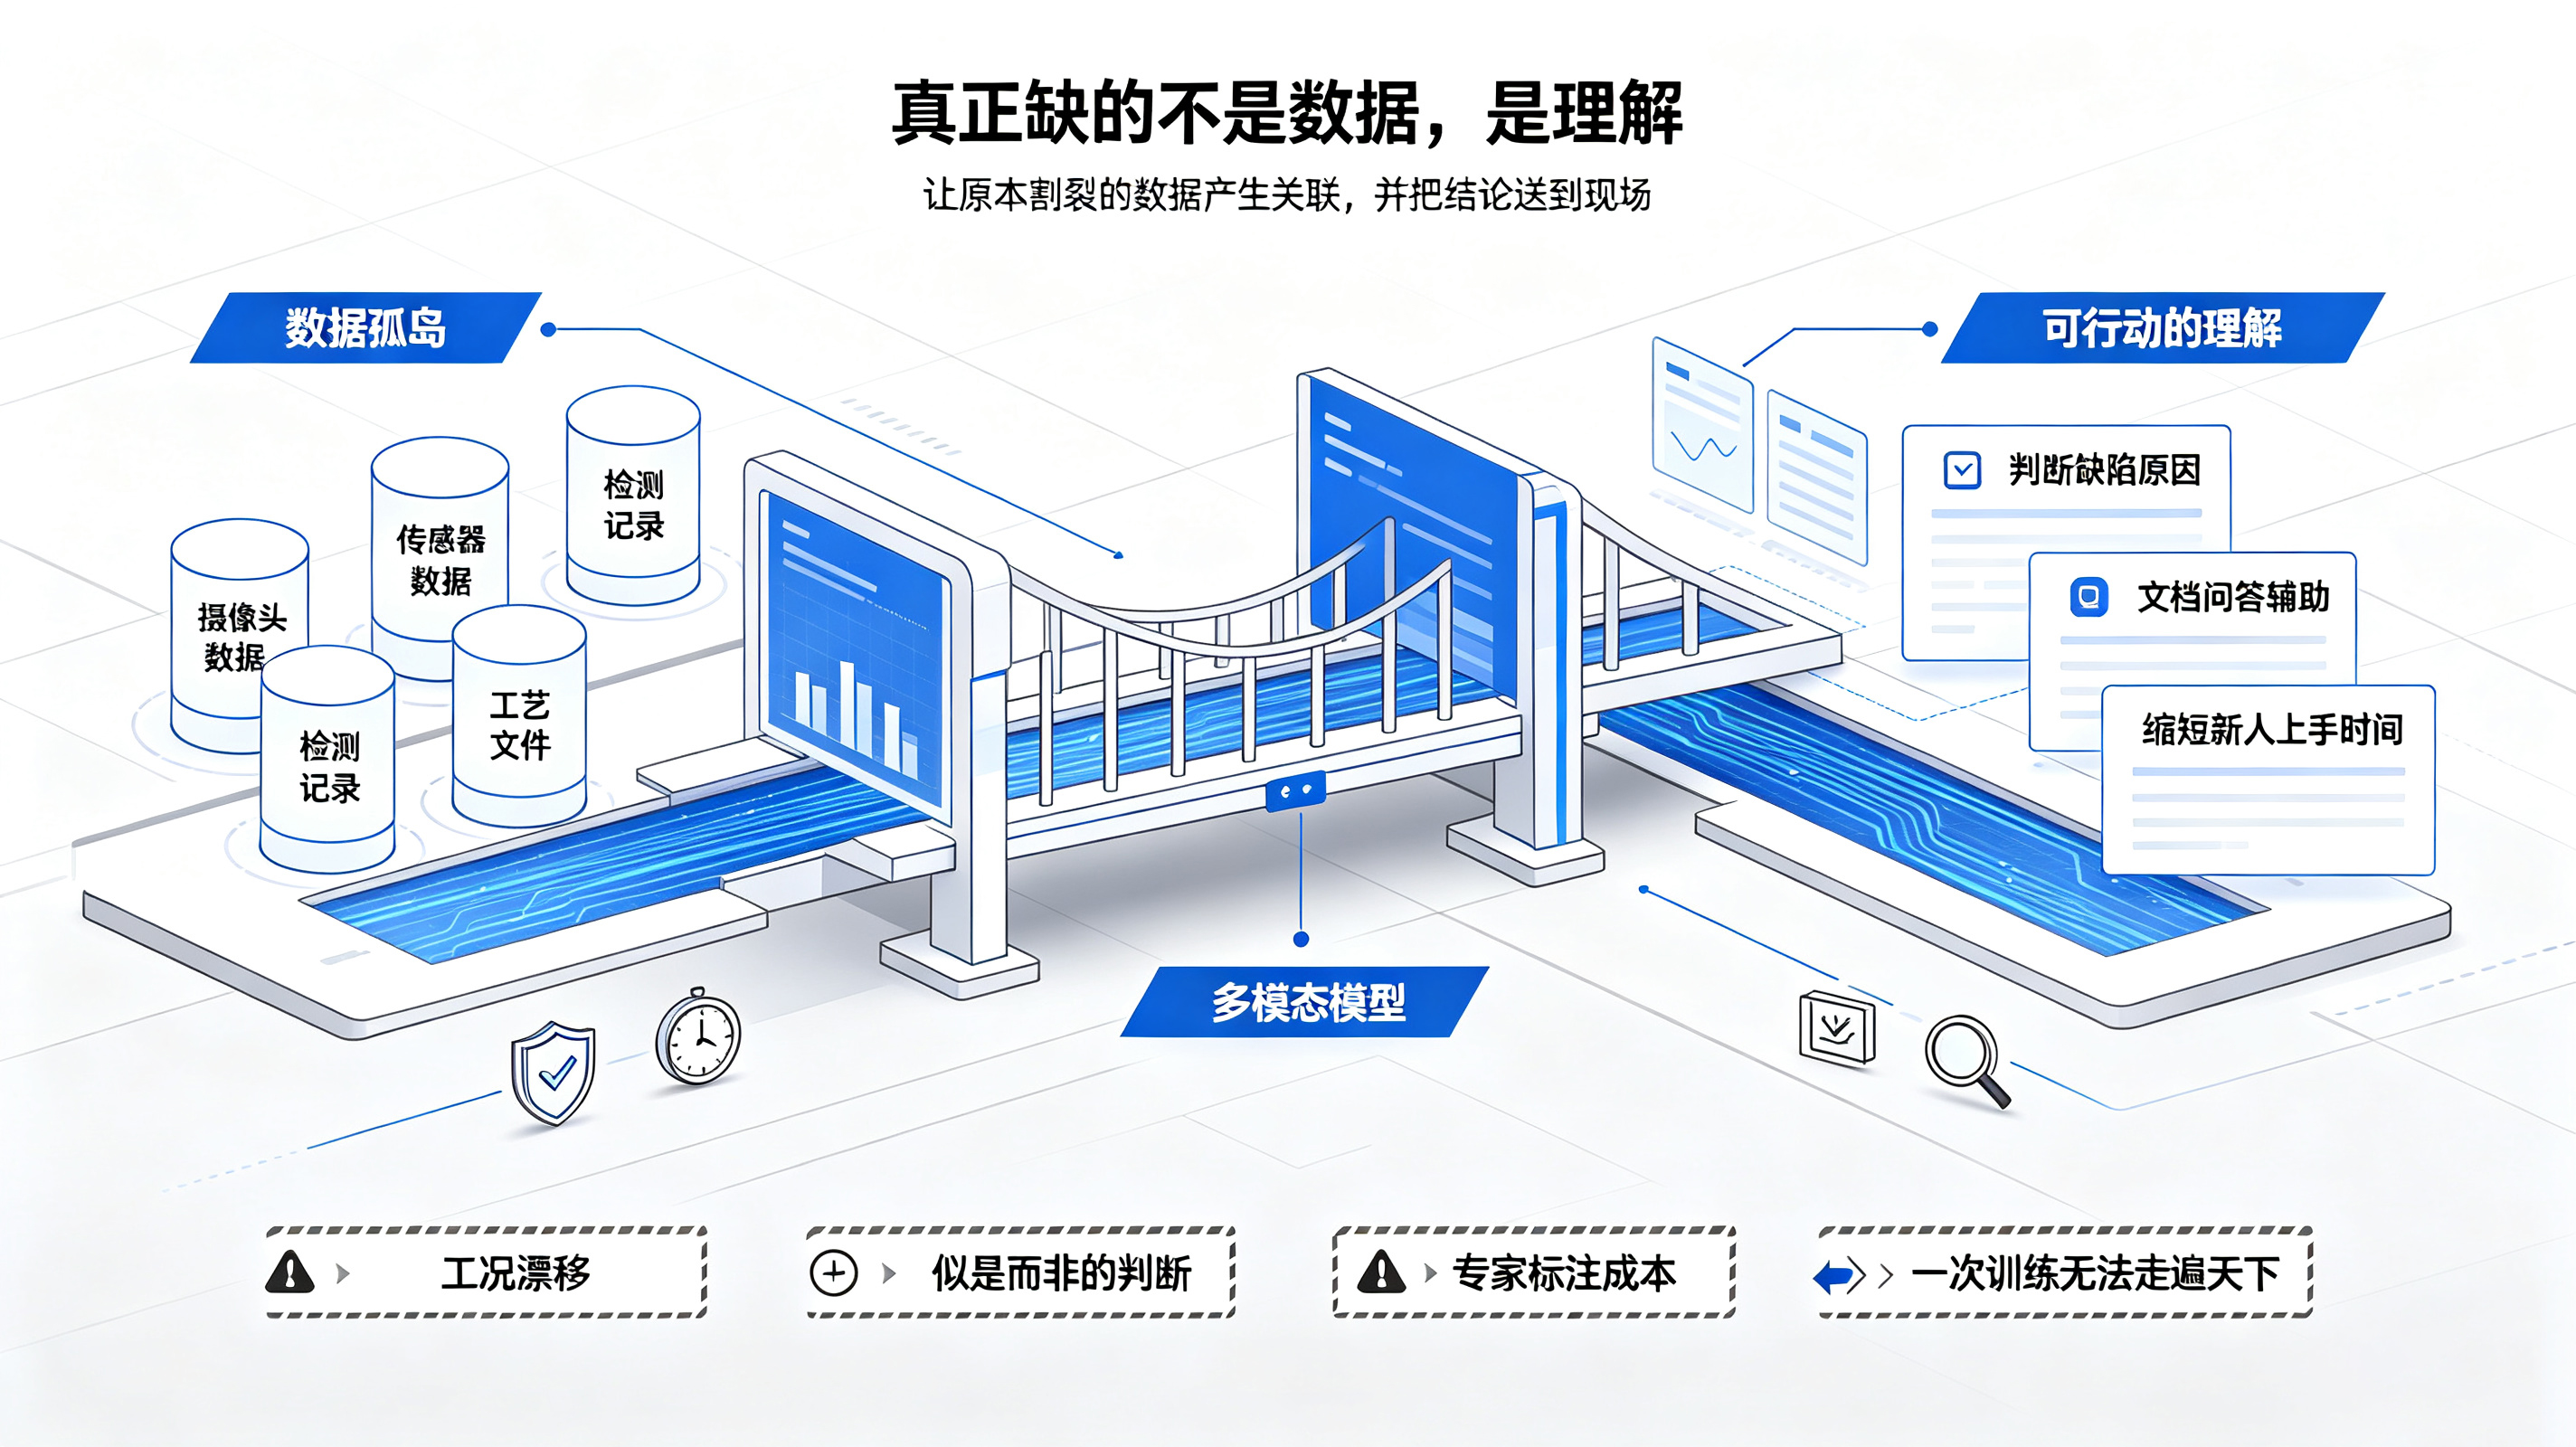
产线上摄像头、传感器、检测设备每天都在产生数据,但这些数据大多以孤岛形式存在,彼此之间没有关联。
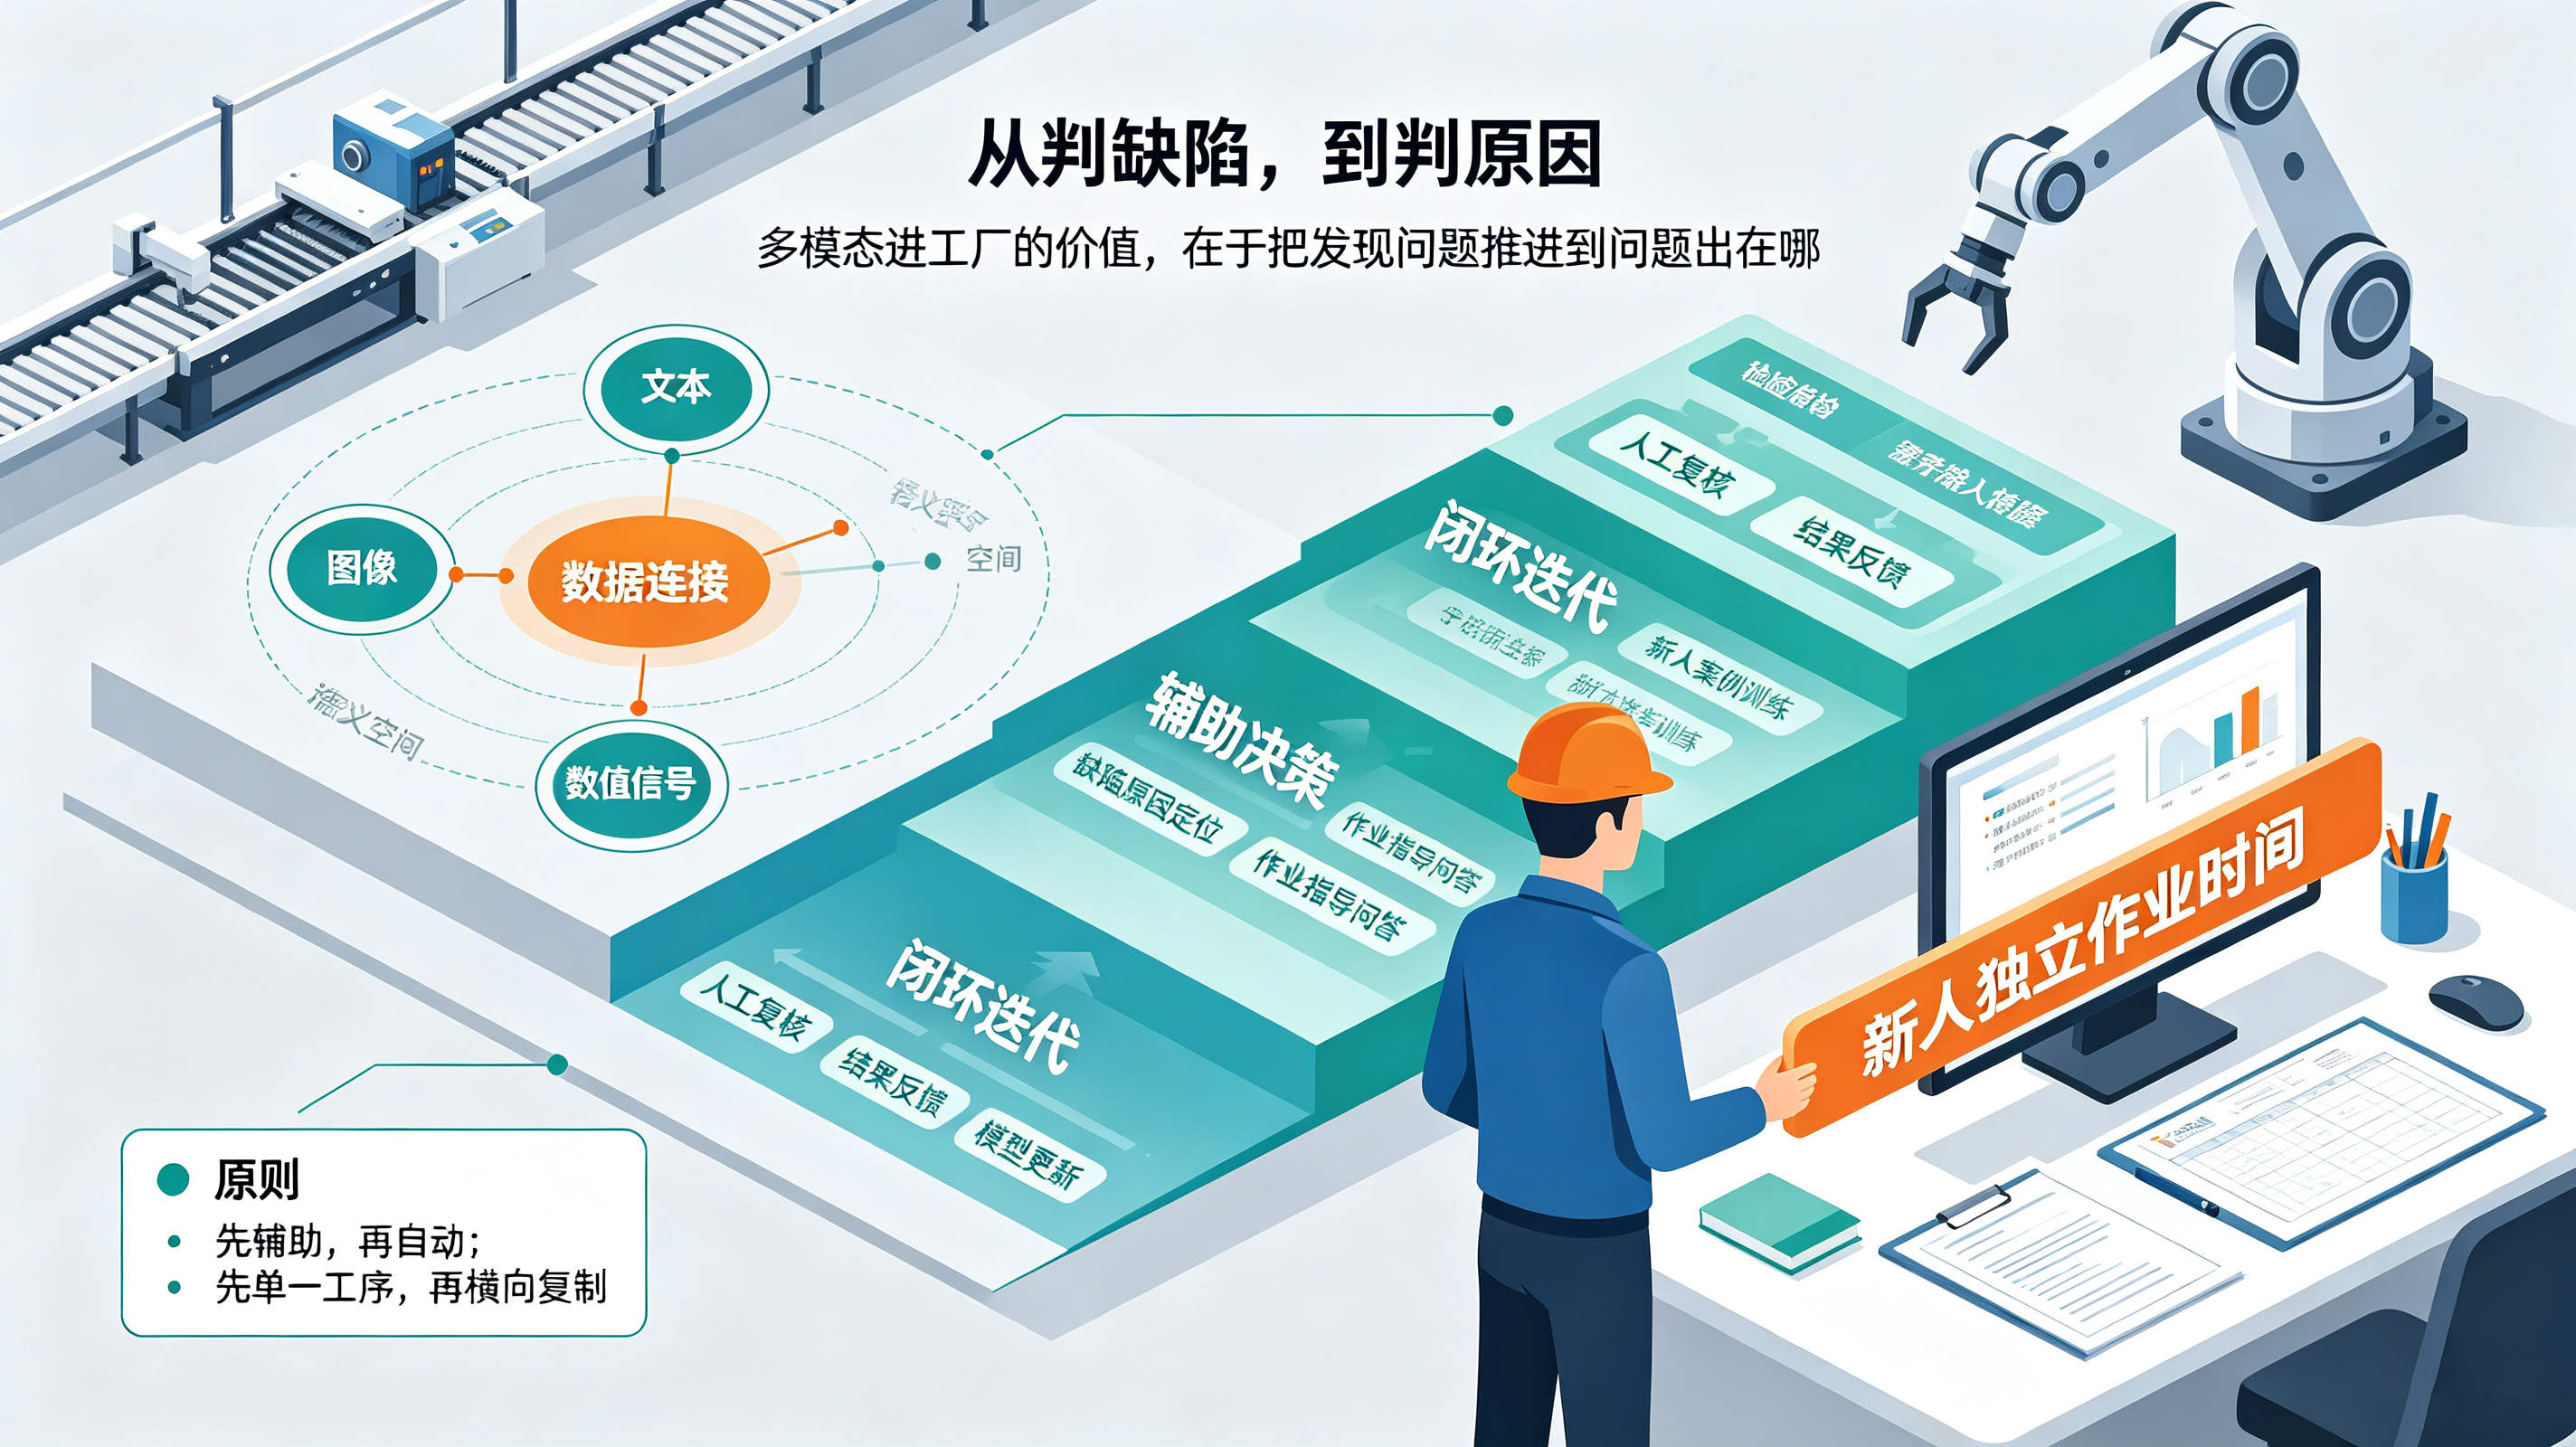
多模态模型的吸引力正在于此:它有可能把图像、文本与数值信号放进同一个语义空间,让原本割裂的数据产生联系。
但这有个前提:案例必须带结果。很多工厂只保存了图片,没有保存后续处置与最终良率,等于只攒了问题、没攒答案。
2、老师傅的经验最难被记录
很多判断依赖"看一眼就知道"的直觉,这种知识无法写进规则,也很难通过问卷采集。
多模态模型能从大量带结果的案例中学习这种关联,这是它相对传统机器视觉最有价值的地方。
二、看得见的收益
1、质检从"判缺陷"走向"判原因"
传统视觉检测能判断有没有缺陷,却很难解释缺陷来自哪道工序。
从判缺陷到判原因,价值差异很大。前者只是把人工复检换成机器,后者才真正触及工艺改进。
多模态模型把图像与工艺参数、设备状态放在一起分析,有机会把"发现了问题"推进到"问题出在哪"。
2、在文档与现场之间搭一座桥
工厂里有大量工艺文件、维修记录、作业指导书,一线人员却很少去翻。
用自然语言或拍照提问就能得到针对性答案,这类应用的接受度往往比预想的高,因为它把使用门槛降到了最低。
3、新人上手的速度
新人成长慢,是因为很多知识只能通过师傅带。把案例、图像与处置方法组织起来,能显著缩短这个过程。
这类收益不容易直接量化,但在人员流动较大的产线上,价值常常超过一次性的效率提升。
衡量它可以看一个新指标:新人达到独立作业标准所需的时间。这个数字的变化往往比良率更能说明问题。
三、看不见的坑
1、光照、角度与工况漂移
实验室里表现良好的模型,换一条产线、换一批光源就可能大幅退化。
这不是模型能力问题,而是数据分布问题。应对办法是持续采集现场数据并保持模型更新,而不是指望一次训练走遍天下。
2、"看起来对"比"明确错"更危险
传统检测漏检会造成损失,但至少是可预期的;模型给出似是而非的判断,反而会让使用者放松警惕。
因此必须设计人工复核机制,并让系统明确表达不确定,而不是永远给出自信的答案。
复核的抽样比例也应当动态调整:系统表现好的时候少抽,波动大的时候多抽,把人力用在最需要的地方。
四、工程上的几个现实
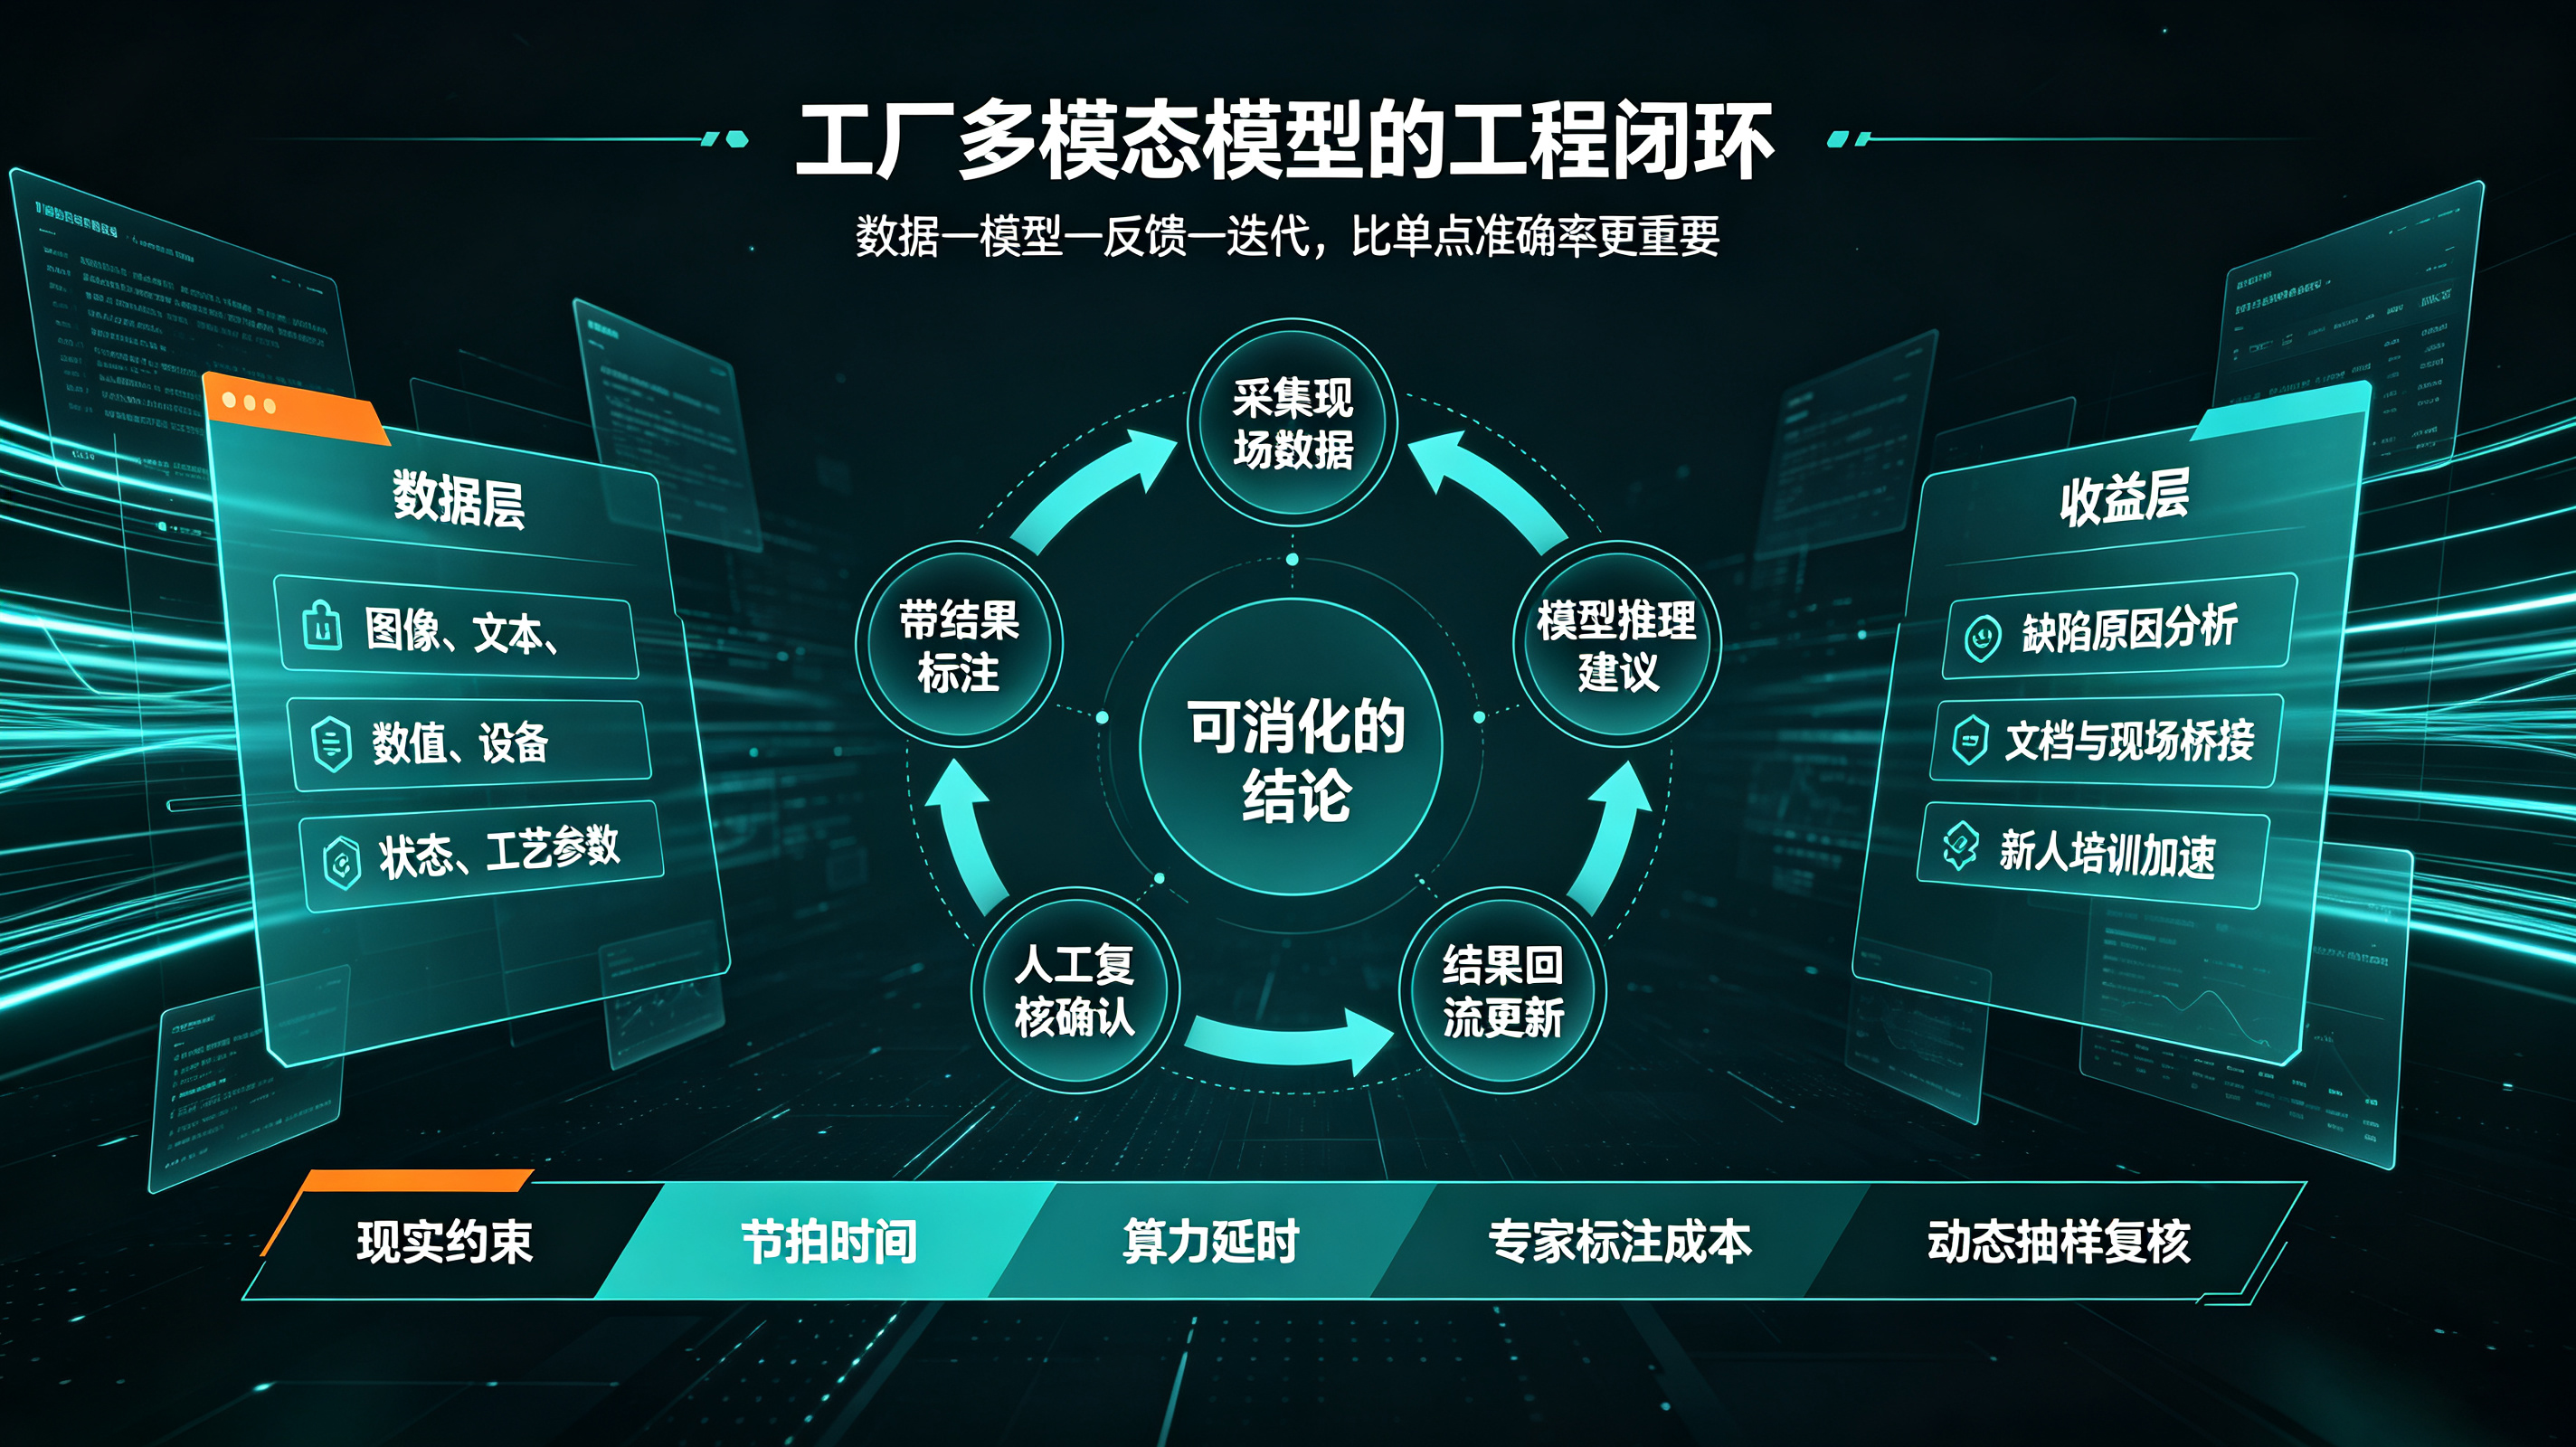
1、算力与延时要按产线节拍算
产线不会等模型。推理必须在节拍时间内完成,否则再准也没有意义。
这意味着模型大小、分辨率、批处理策略都要围绕节拍来设计,而不是先选模型再想办法适配。
2、标注成本集中在专家时间
工业数据的标注往往必须由有经验的工程师完成,他们的时间才是真正的瓶颈。
与其追求标注数量,不如先把标注体系设计清楚,让有限的专家时间产生最大的信息量。
一个实用的技巧是让专家只做判定、不做整理,把整理工作交给工具,让专家的每一分钟都花在真正的判断上。
五、推进顺序上的建议
1、先做辅助,再做自动
让模型先给出建议、由人确认,既能积累数据,也能建立信任,比一步到位全自动稳妥得多。
等到建议的采纳率稳定在高位,再逐步放开自动化程度,风险才可控。
2、先做单一工序,再横向复制
在一个工序上打通"数据—模型—反馈—迭代"的完整闭环,比同时在多个工序铺开更有价值。
闭环一旦成型,复制到其他工序的成本会显著下降,这才是规模化的正确顺序。
复制到其他工序时还要警惕照搬:不同工序的数据分布与节拍差异很大,模板可以复用,参数必须重校。
多模态进工厂真正的难点,从来不是模型能不能看懂,而是它看懂之后,工厂有没有能力消化这个结论。

