
具身智能训练为何离不开物理交互数据
一、为什么视频和语言数据撑不起机器人
1、看懂与能做到之间隔着执行
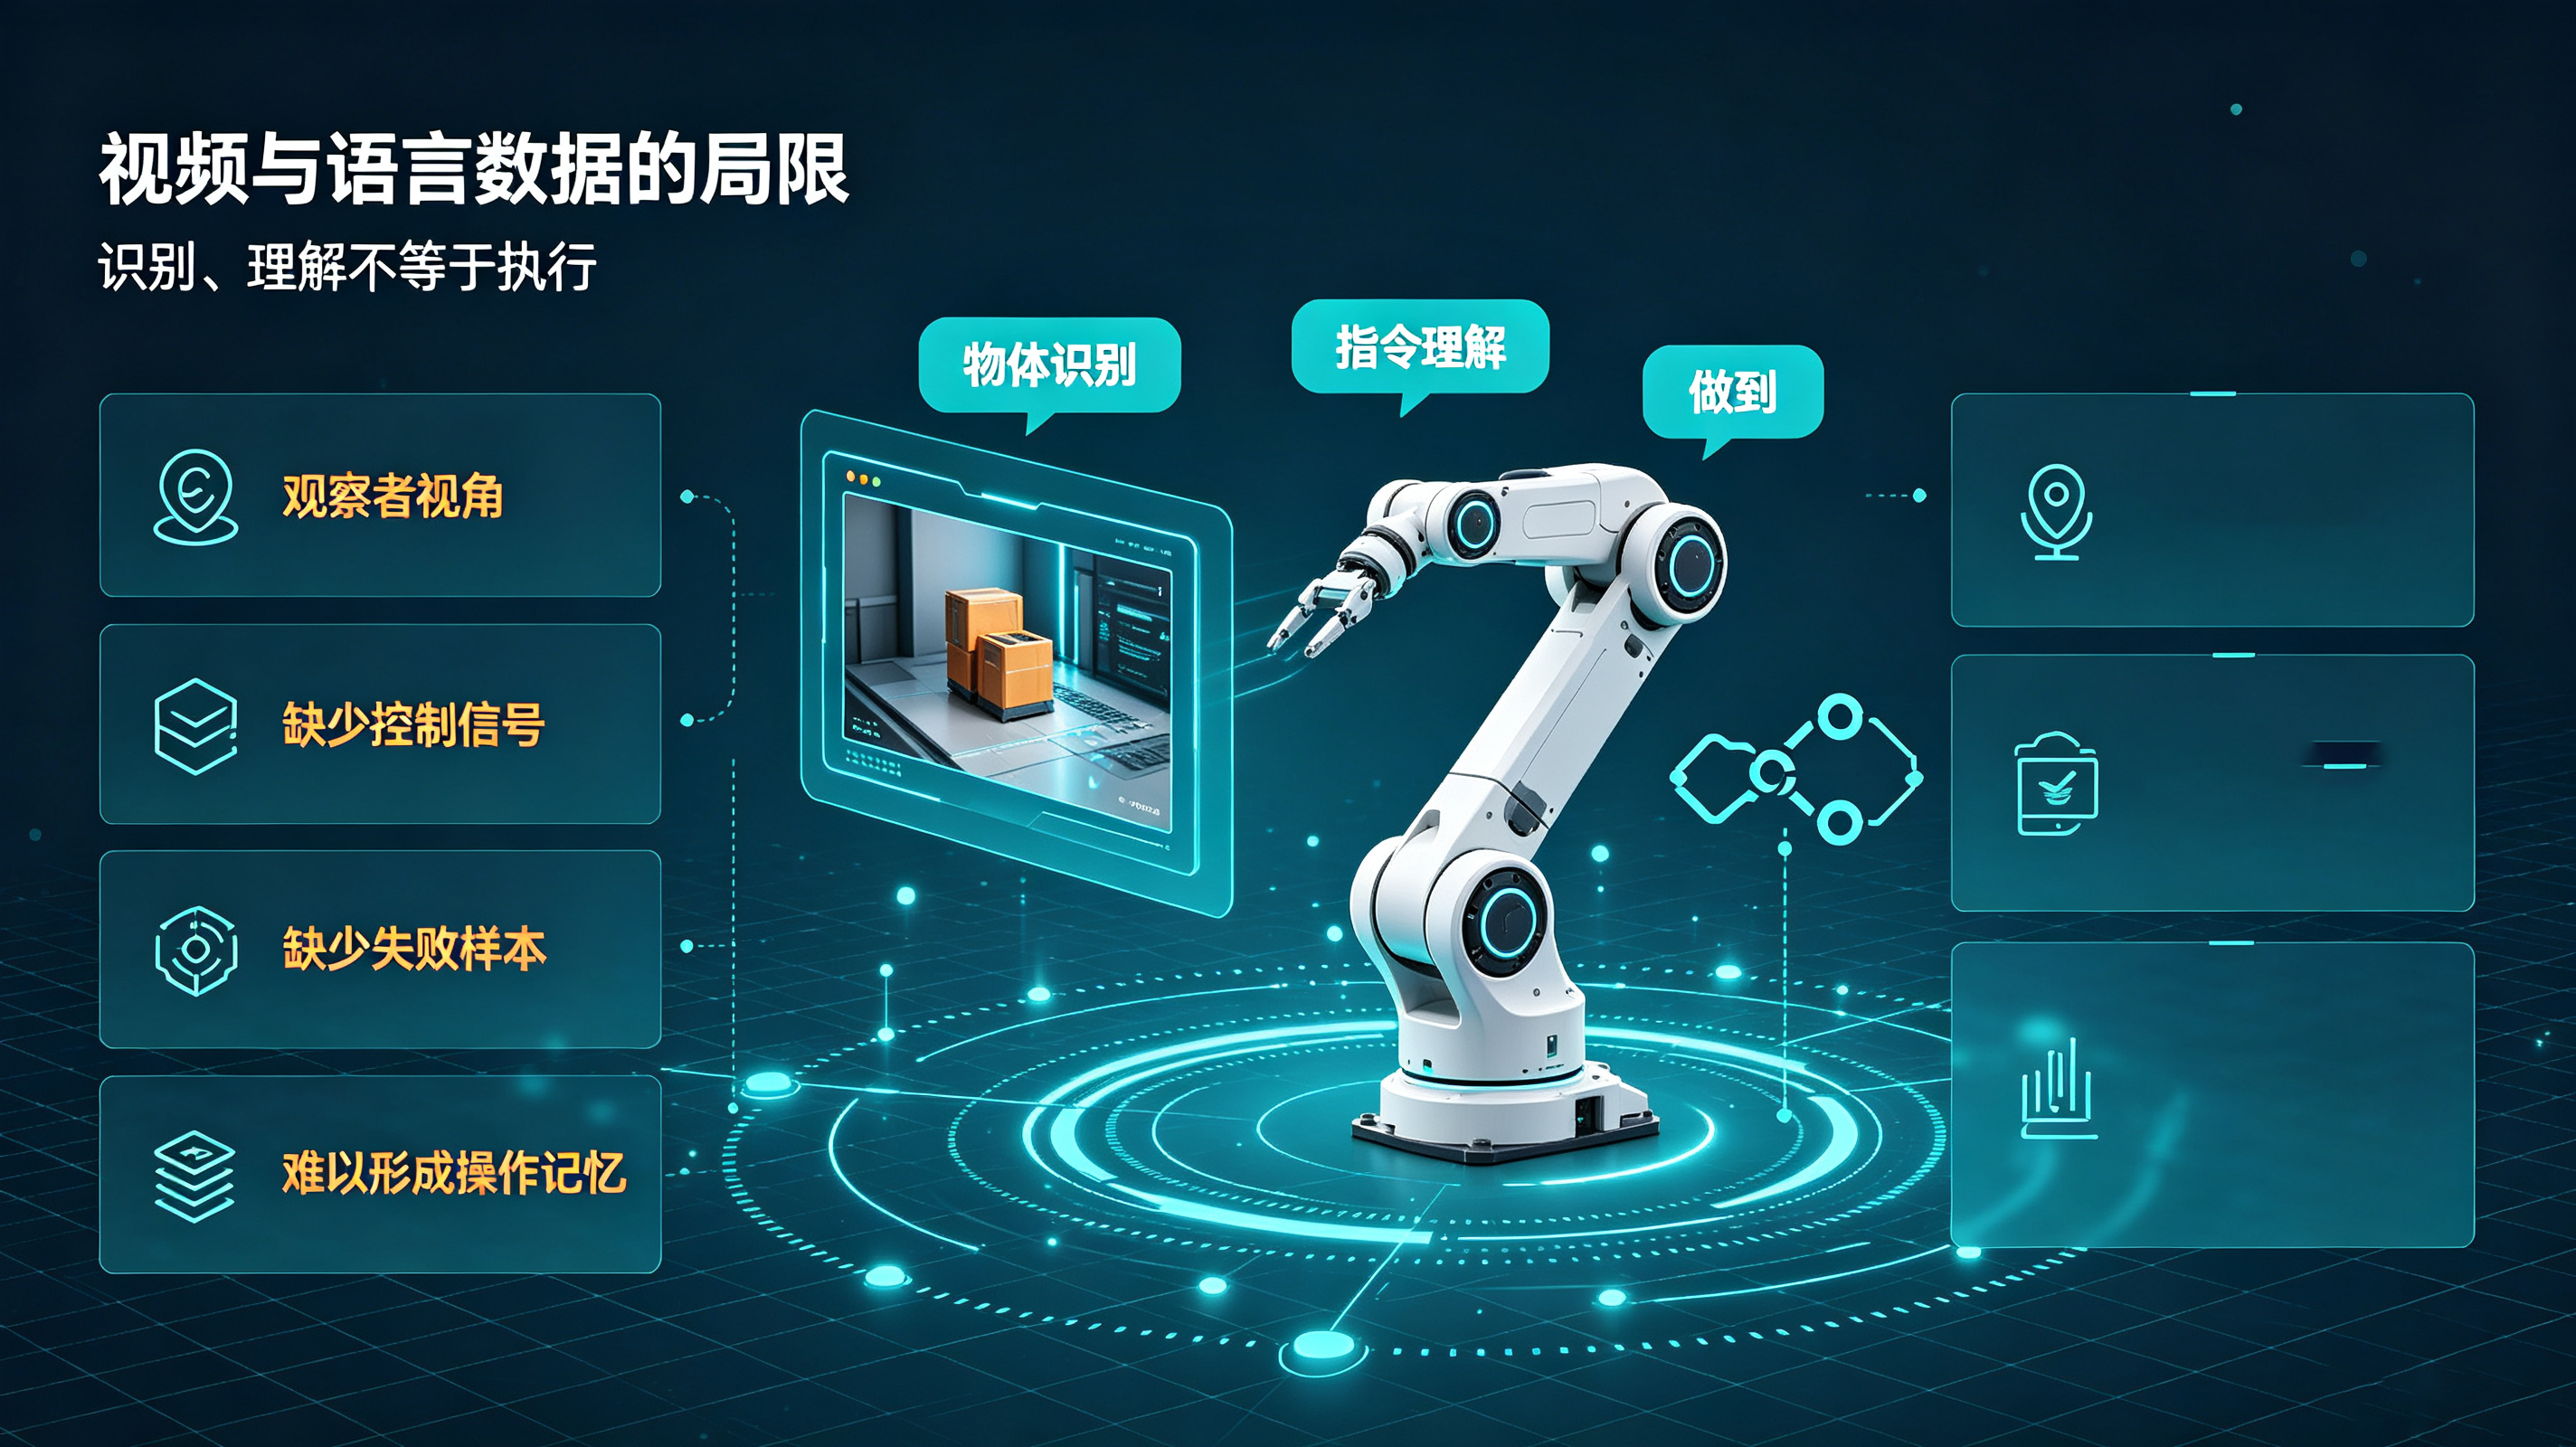
大模型见过海量视频与文字,能识别物体、读懂指令,但机器人要把这件事真正做出来,需要的不仅是"知道",还有"做得到"。这两者之间的鸿沟,只能靠身体在世界里反复试错来填补。
语言数据的魅力在于它可以脱离采集者独立存在——写下来就在那里,复制一份的成本几乎为零。机器人数据没有这个性质,每一条轨迹都必须由一台真实的机器在真实的空间里跑出来,复制意味着重跑一遍。
2、视频里没有"动作的结果"
视频能告诉你抓取开始时物体在哪、结束时它在手里,但中间过程是被动观测的:控制信号、接触力、失败模式都看不到。模型学不到失败,就学不到鲁棒。
换句话说,视频给出的是观察者视角,不是操作者视角。要让模型学会"操作",数据必须从操作者的角度被记录,把动作、受力与视觉变化绑在同一条时间线上。
二、物理交互数据的独特价值
1、它包含真实的因果
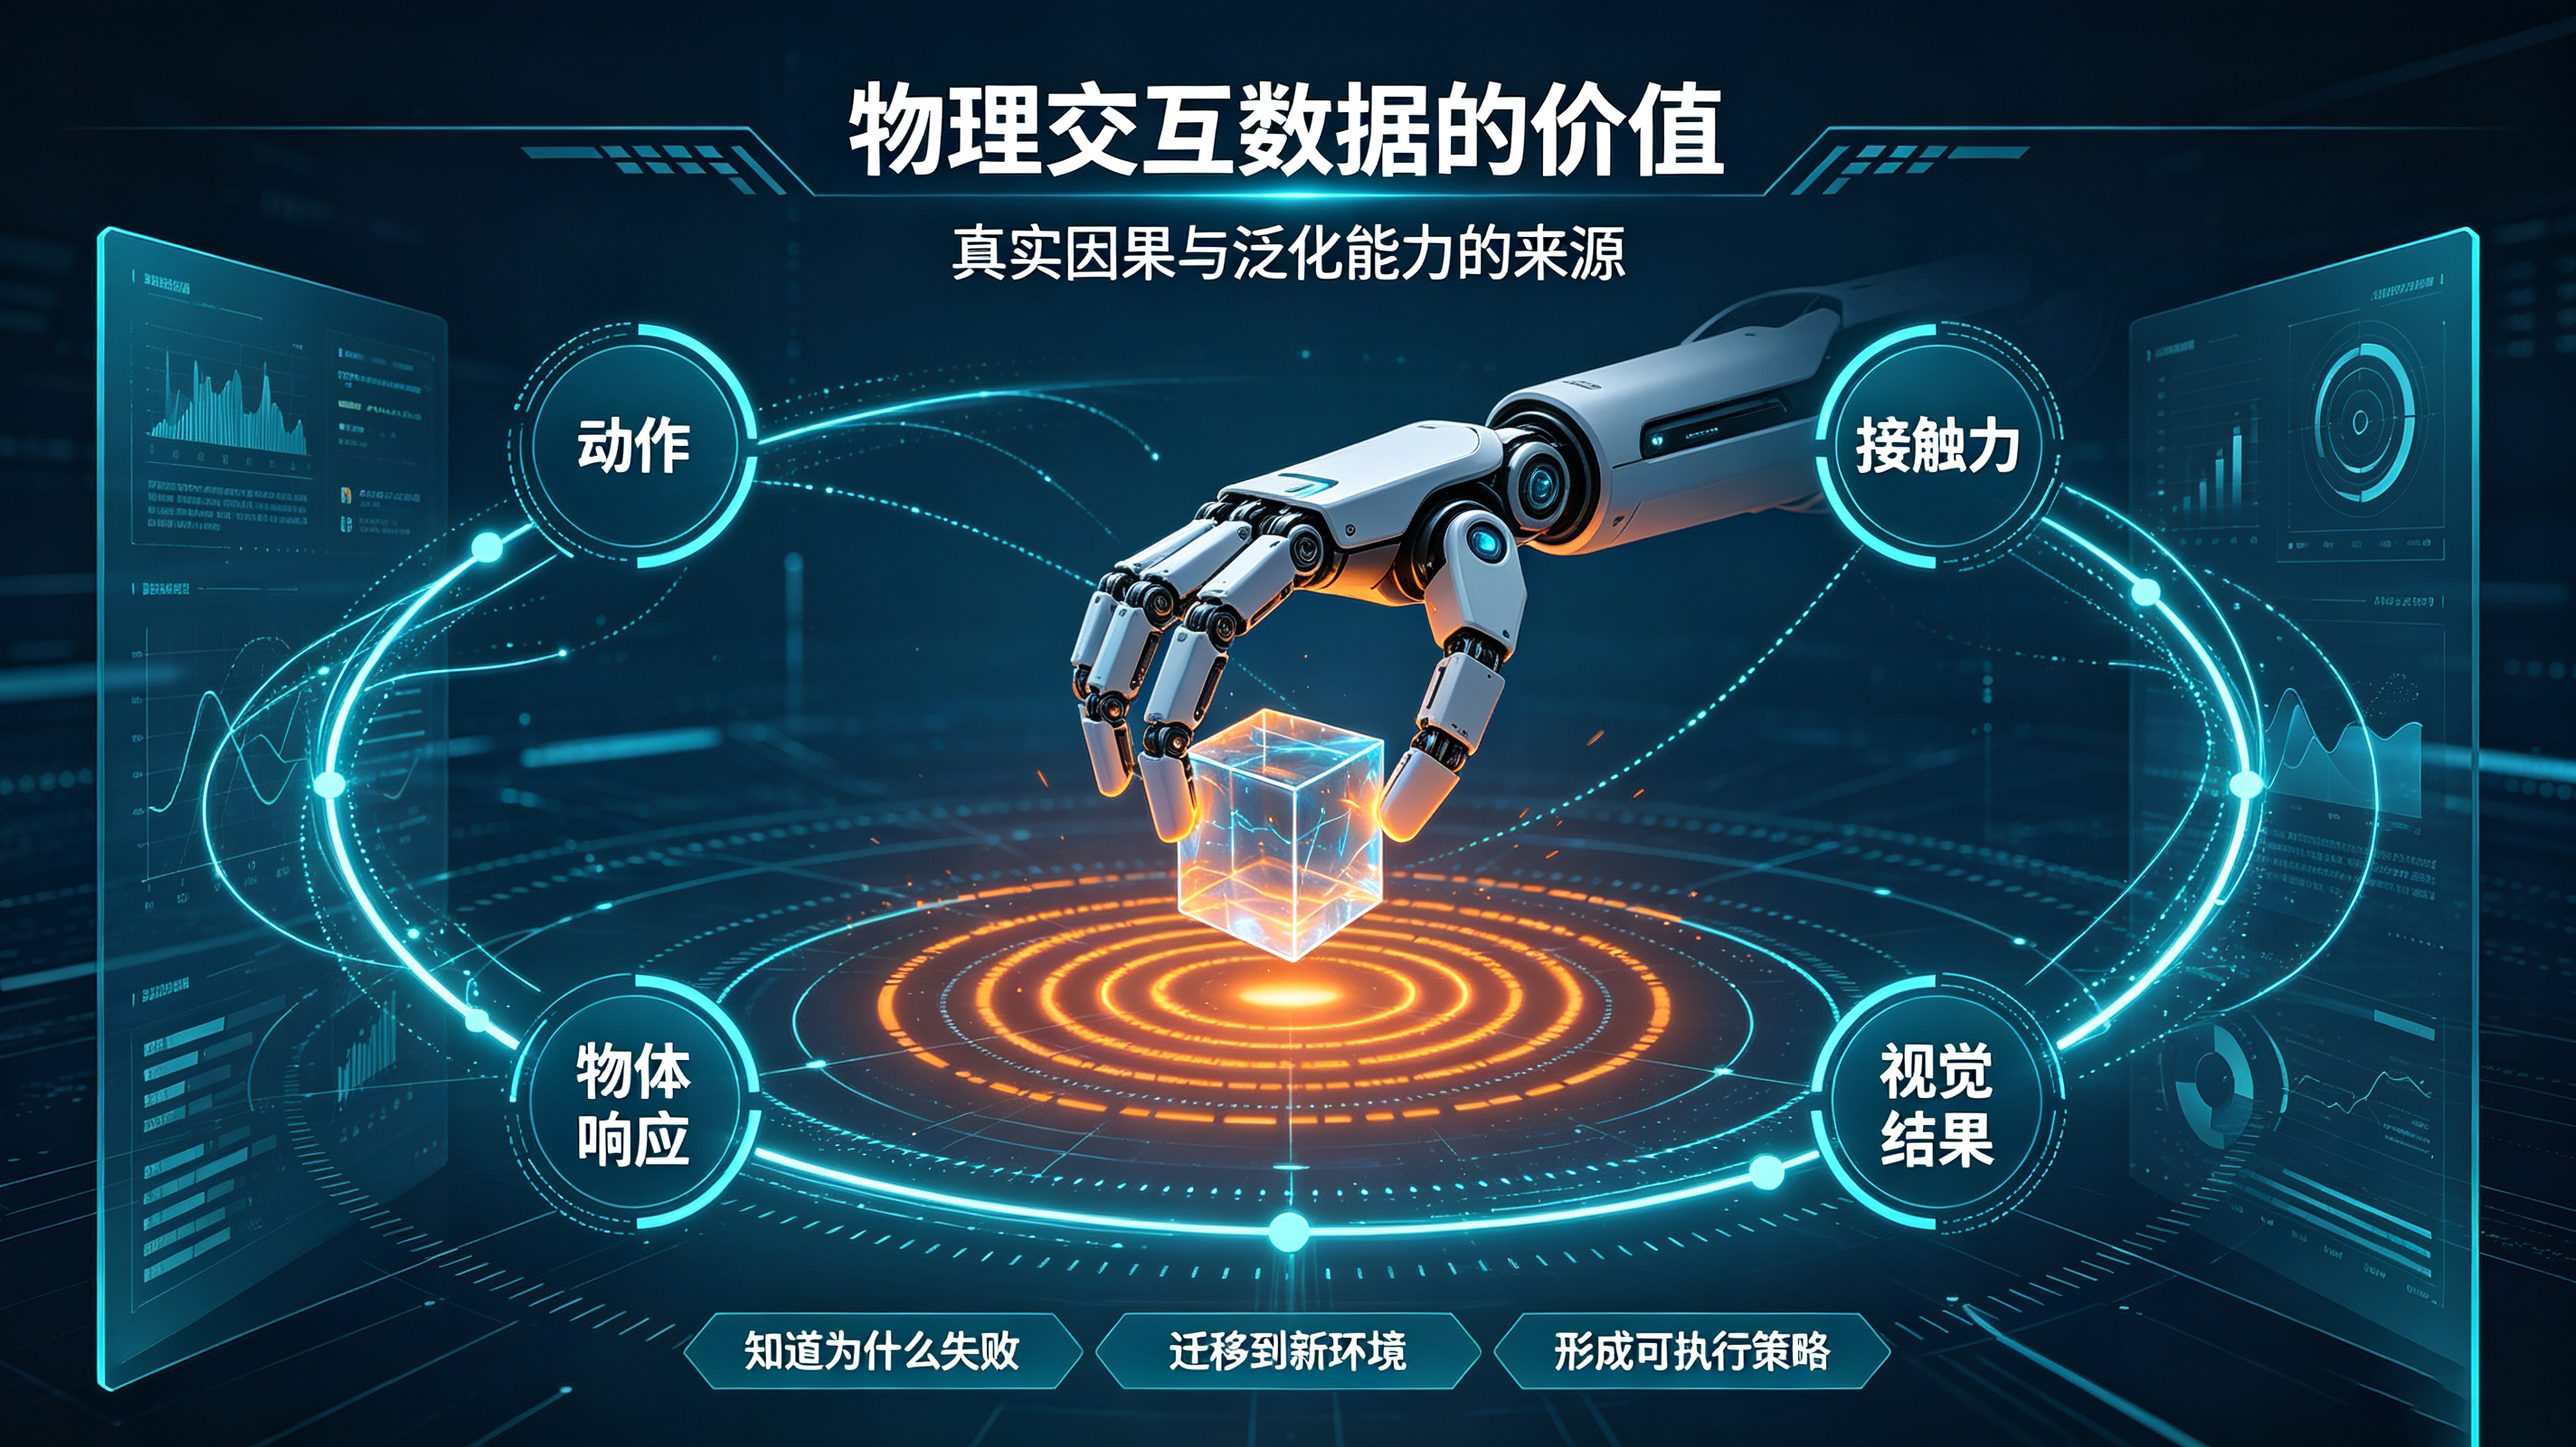
每一次抓取、推压、碰撞都对应一段因果链:动作发出、力反馈、物体响应、视觉变化。模型只有看见完整链条,才能学到"为什么这次成功、那次失败"。
监督信号的来源也因此不同。语言模型的标签来自文本本身,而机器人数据的标签来自世界的回应——你推一下,物体动或不动,这个回应无法由标注者凭空写出来。
2、它是泛化的基础
换一种物体、换一个光照、换一个起始位置,结果会怎么变,只有真机数据能教。仿真可以近似,但终究只是近似。
但真机数据不可能穷尽所有组合,能学到的是从有限样本里抽象出对环境的一般性理解。这也是为什么这个领域真正比拼的是数据效率,而不是单纯的采集量。
三、现实采集的三个痛点
1、成本高、效率低
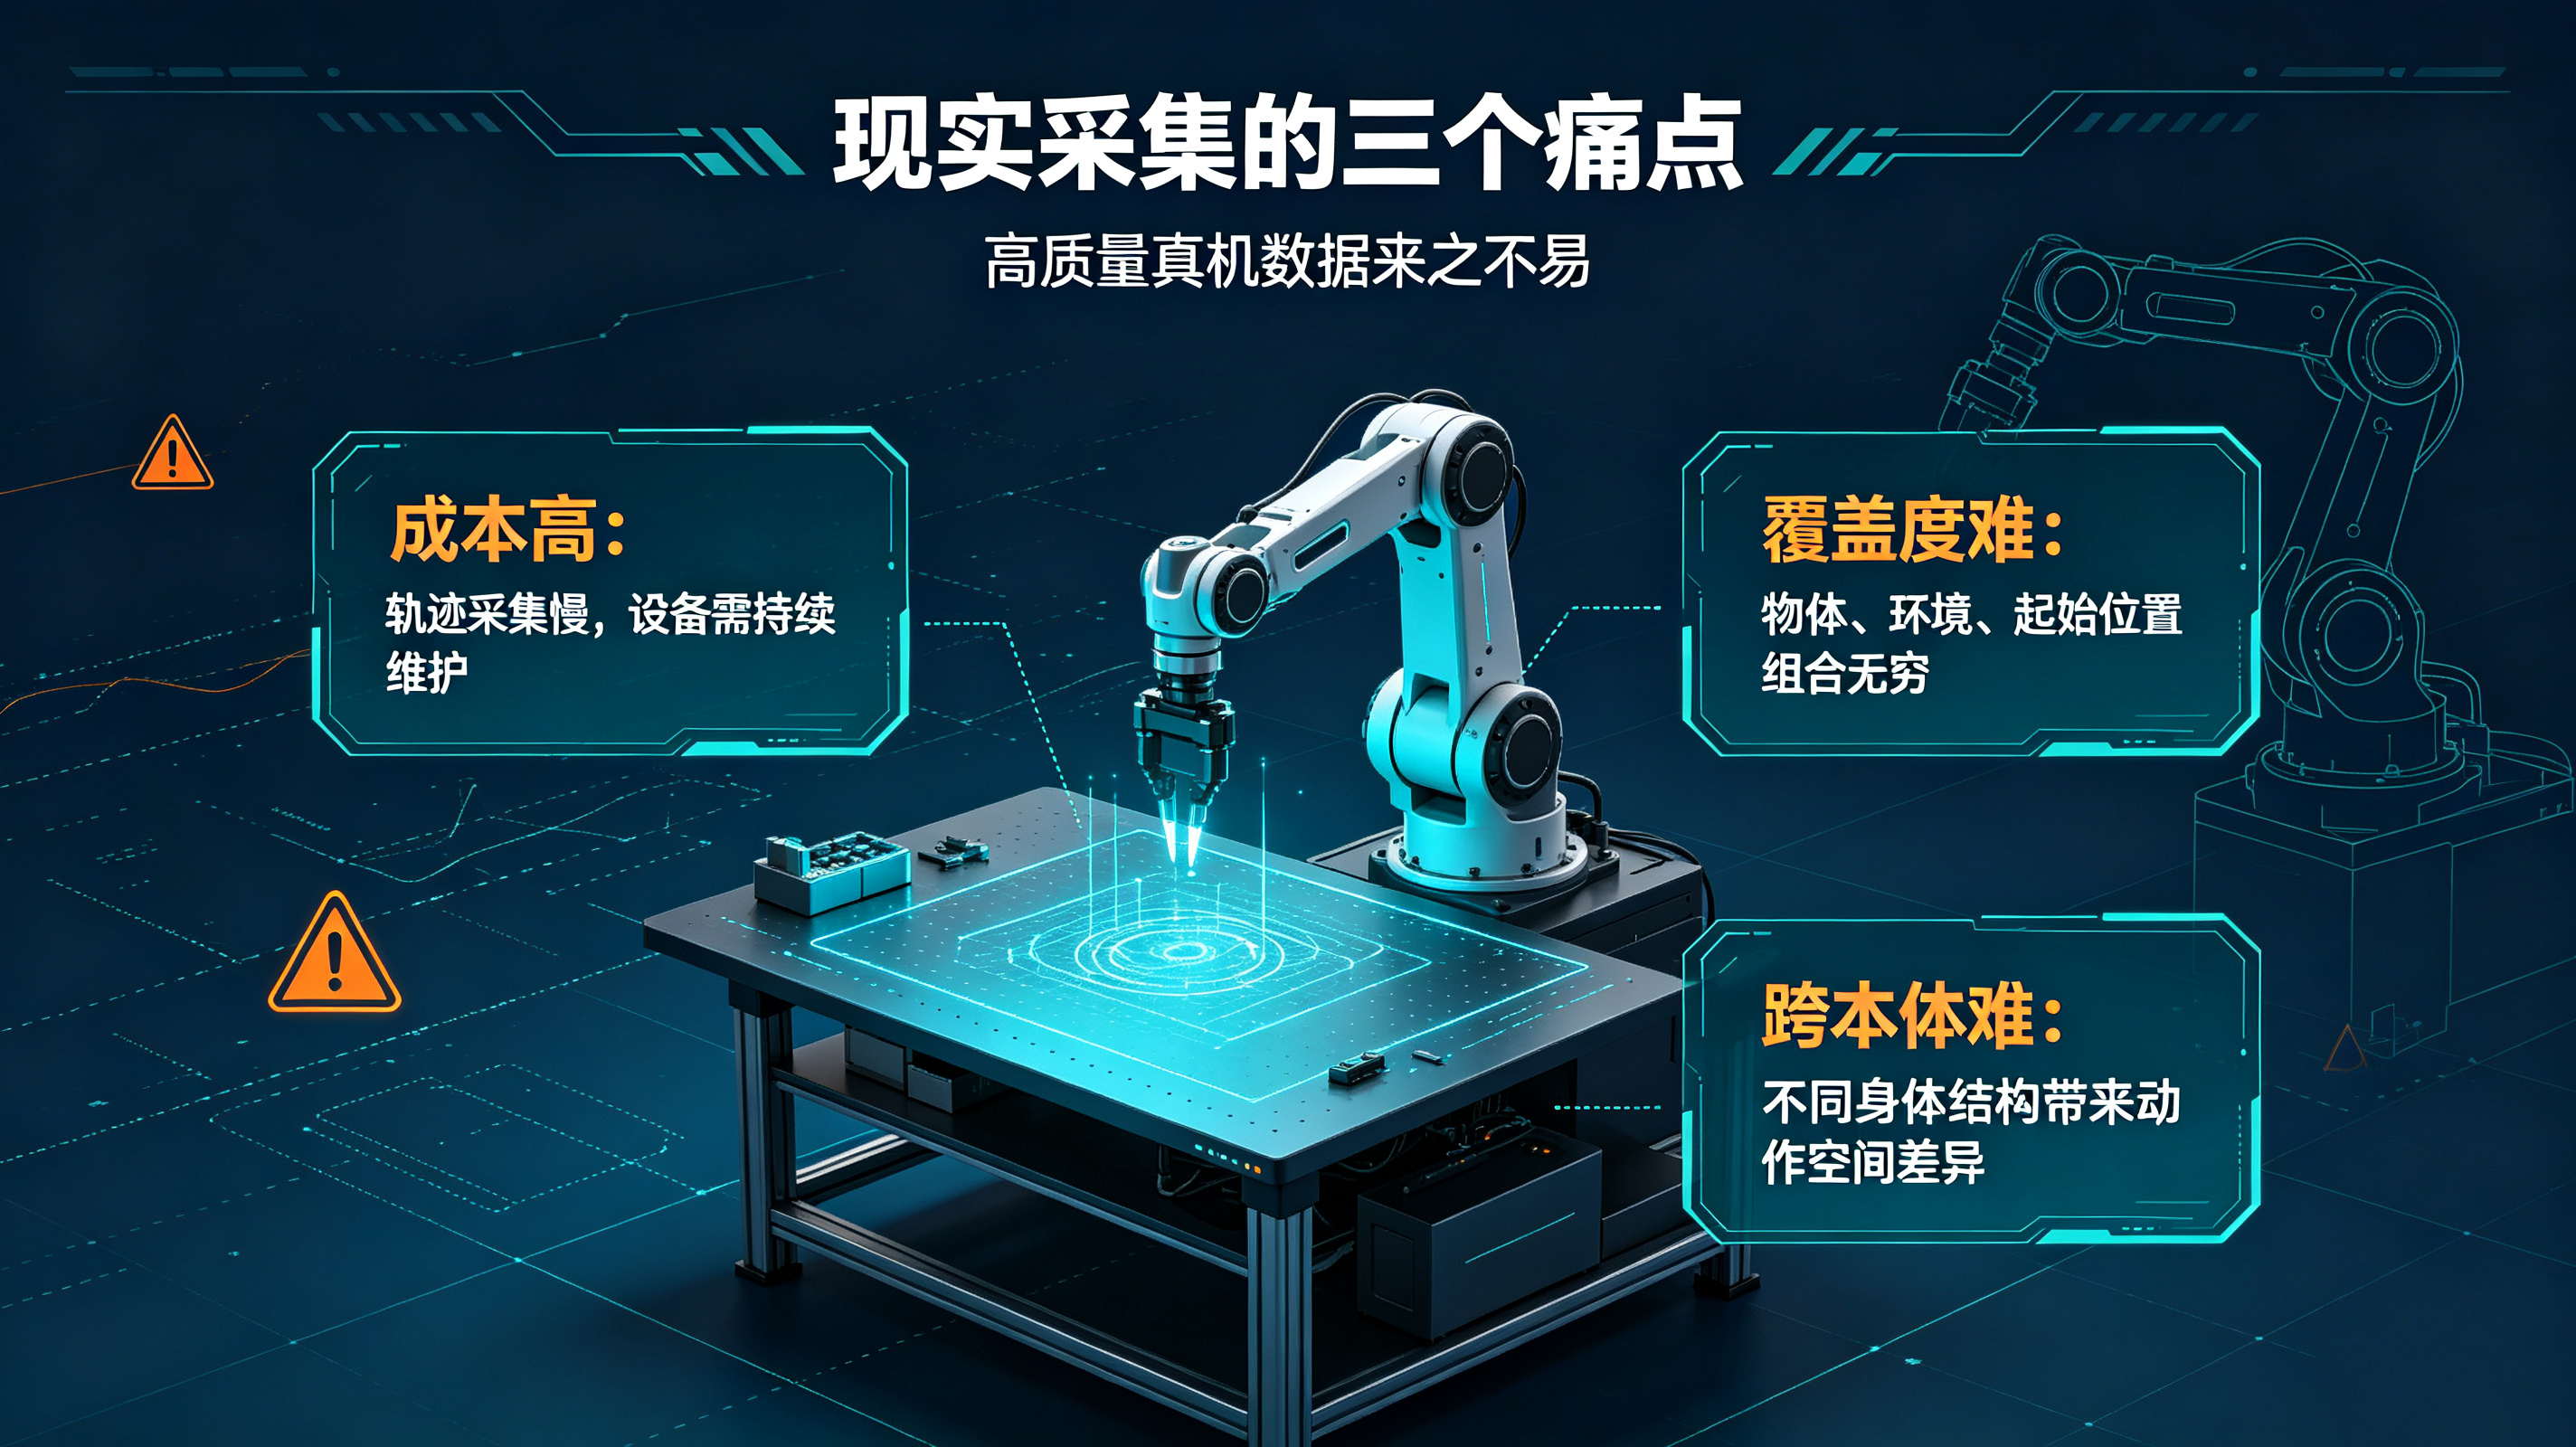
一条轨迹动辄几分钟,机器人还要看护、保养、重置场景,规模化采集的代价远超语言数据。这是这个领域最被低估的瓶颈之一。
降低成本的方向包括自动化采集、远程遥操与众包,但每种方式都有自己的折中:自动化牺牲多样性,遥操受限于操作员水平,众包则难以保证一致性。
2、覆盖度与跨本体局限
现实中的物体、操作、环境组合无穷多,穷举不可能,必须靠设计有代表性的采集方案,否则会陷入"看到的都会、没看到的全废"的窘境。
跨本体更难:轮式机械臂采集的数据对人形机器人帮助有限,因为身体结构不同、动作空间也不同。这是"通用具身"最难解决的问题之一。
四、与仿真数据的关系
1、仿真提供数量,真机提供质量
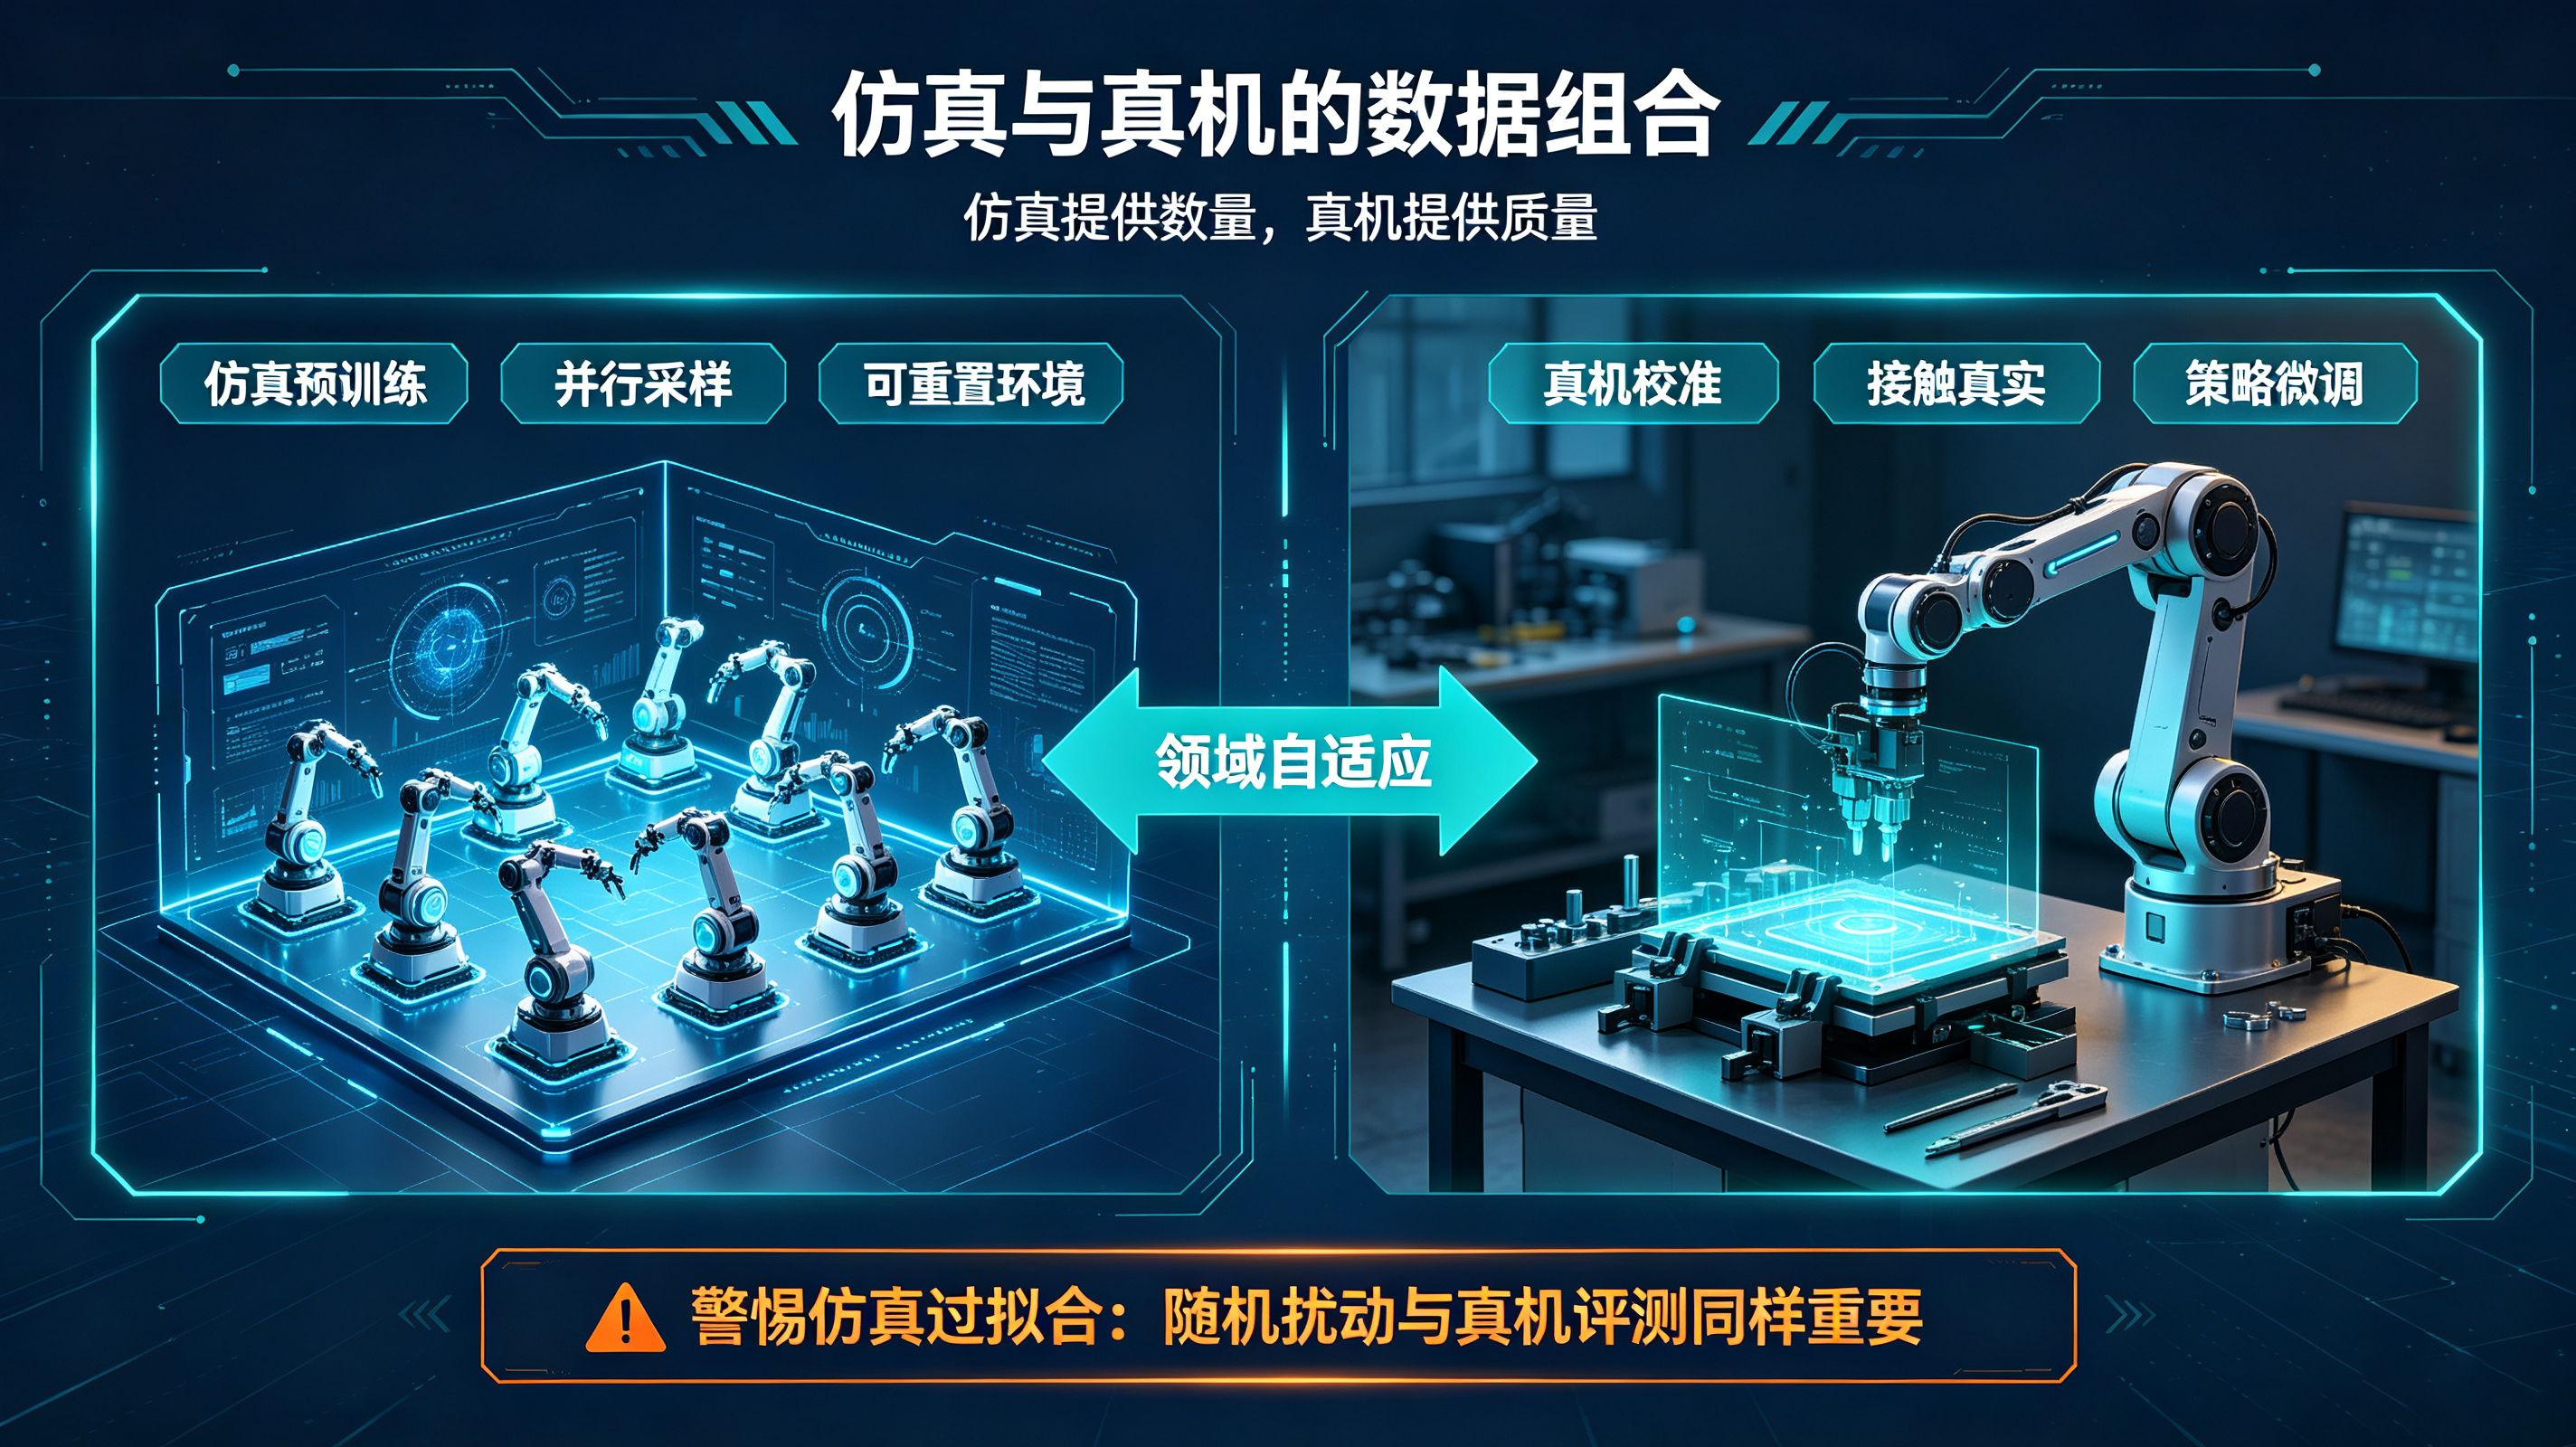
仿真的优势是并行与可重置,劣势是物理近似;真机恰好相反。先在仿真里做大规模预训练,再用真机数据做校准与微调,是当前常见的折中方案。
这套组合真正的关键在于仿真与真机的差距能否被弥补。如果差距太大,仿真里学到的东西迁移不过来,规模再大也只是自我循环。
2、仿真过拟合的风险
策略可能在仿真里表现优异,却只学会了利用仿真器的建模缺陷。缓解办法是始终把真机评测当作唯一金标准,而不是看仿真里的漂亮数字。
因此要刻意在训练时引入随机与扰动,避免策略记住特定偏置。这条经验来自长期实践,如今已是行业里的共识。
五、未来几年真正比拼的是什么
1、谁能持续采到高质量真机数据
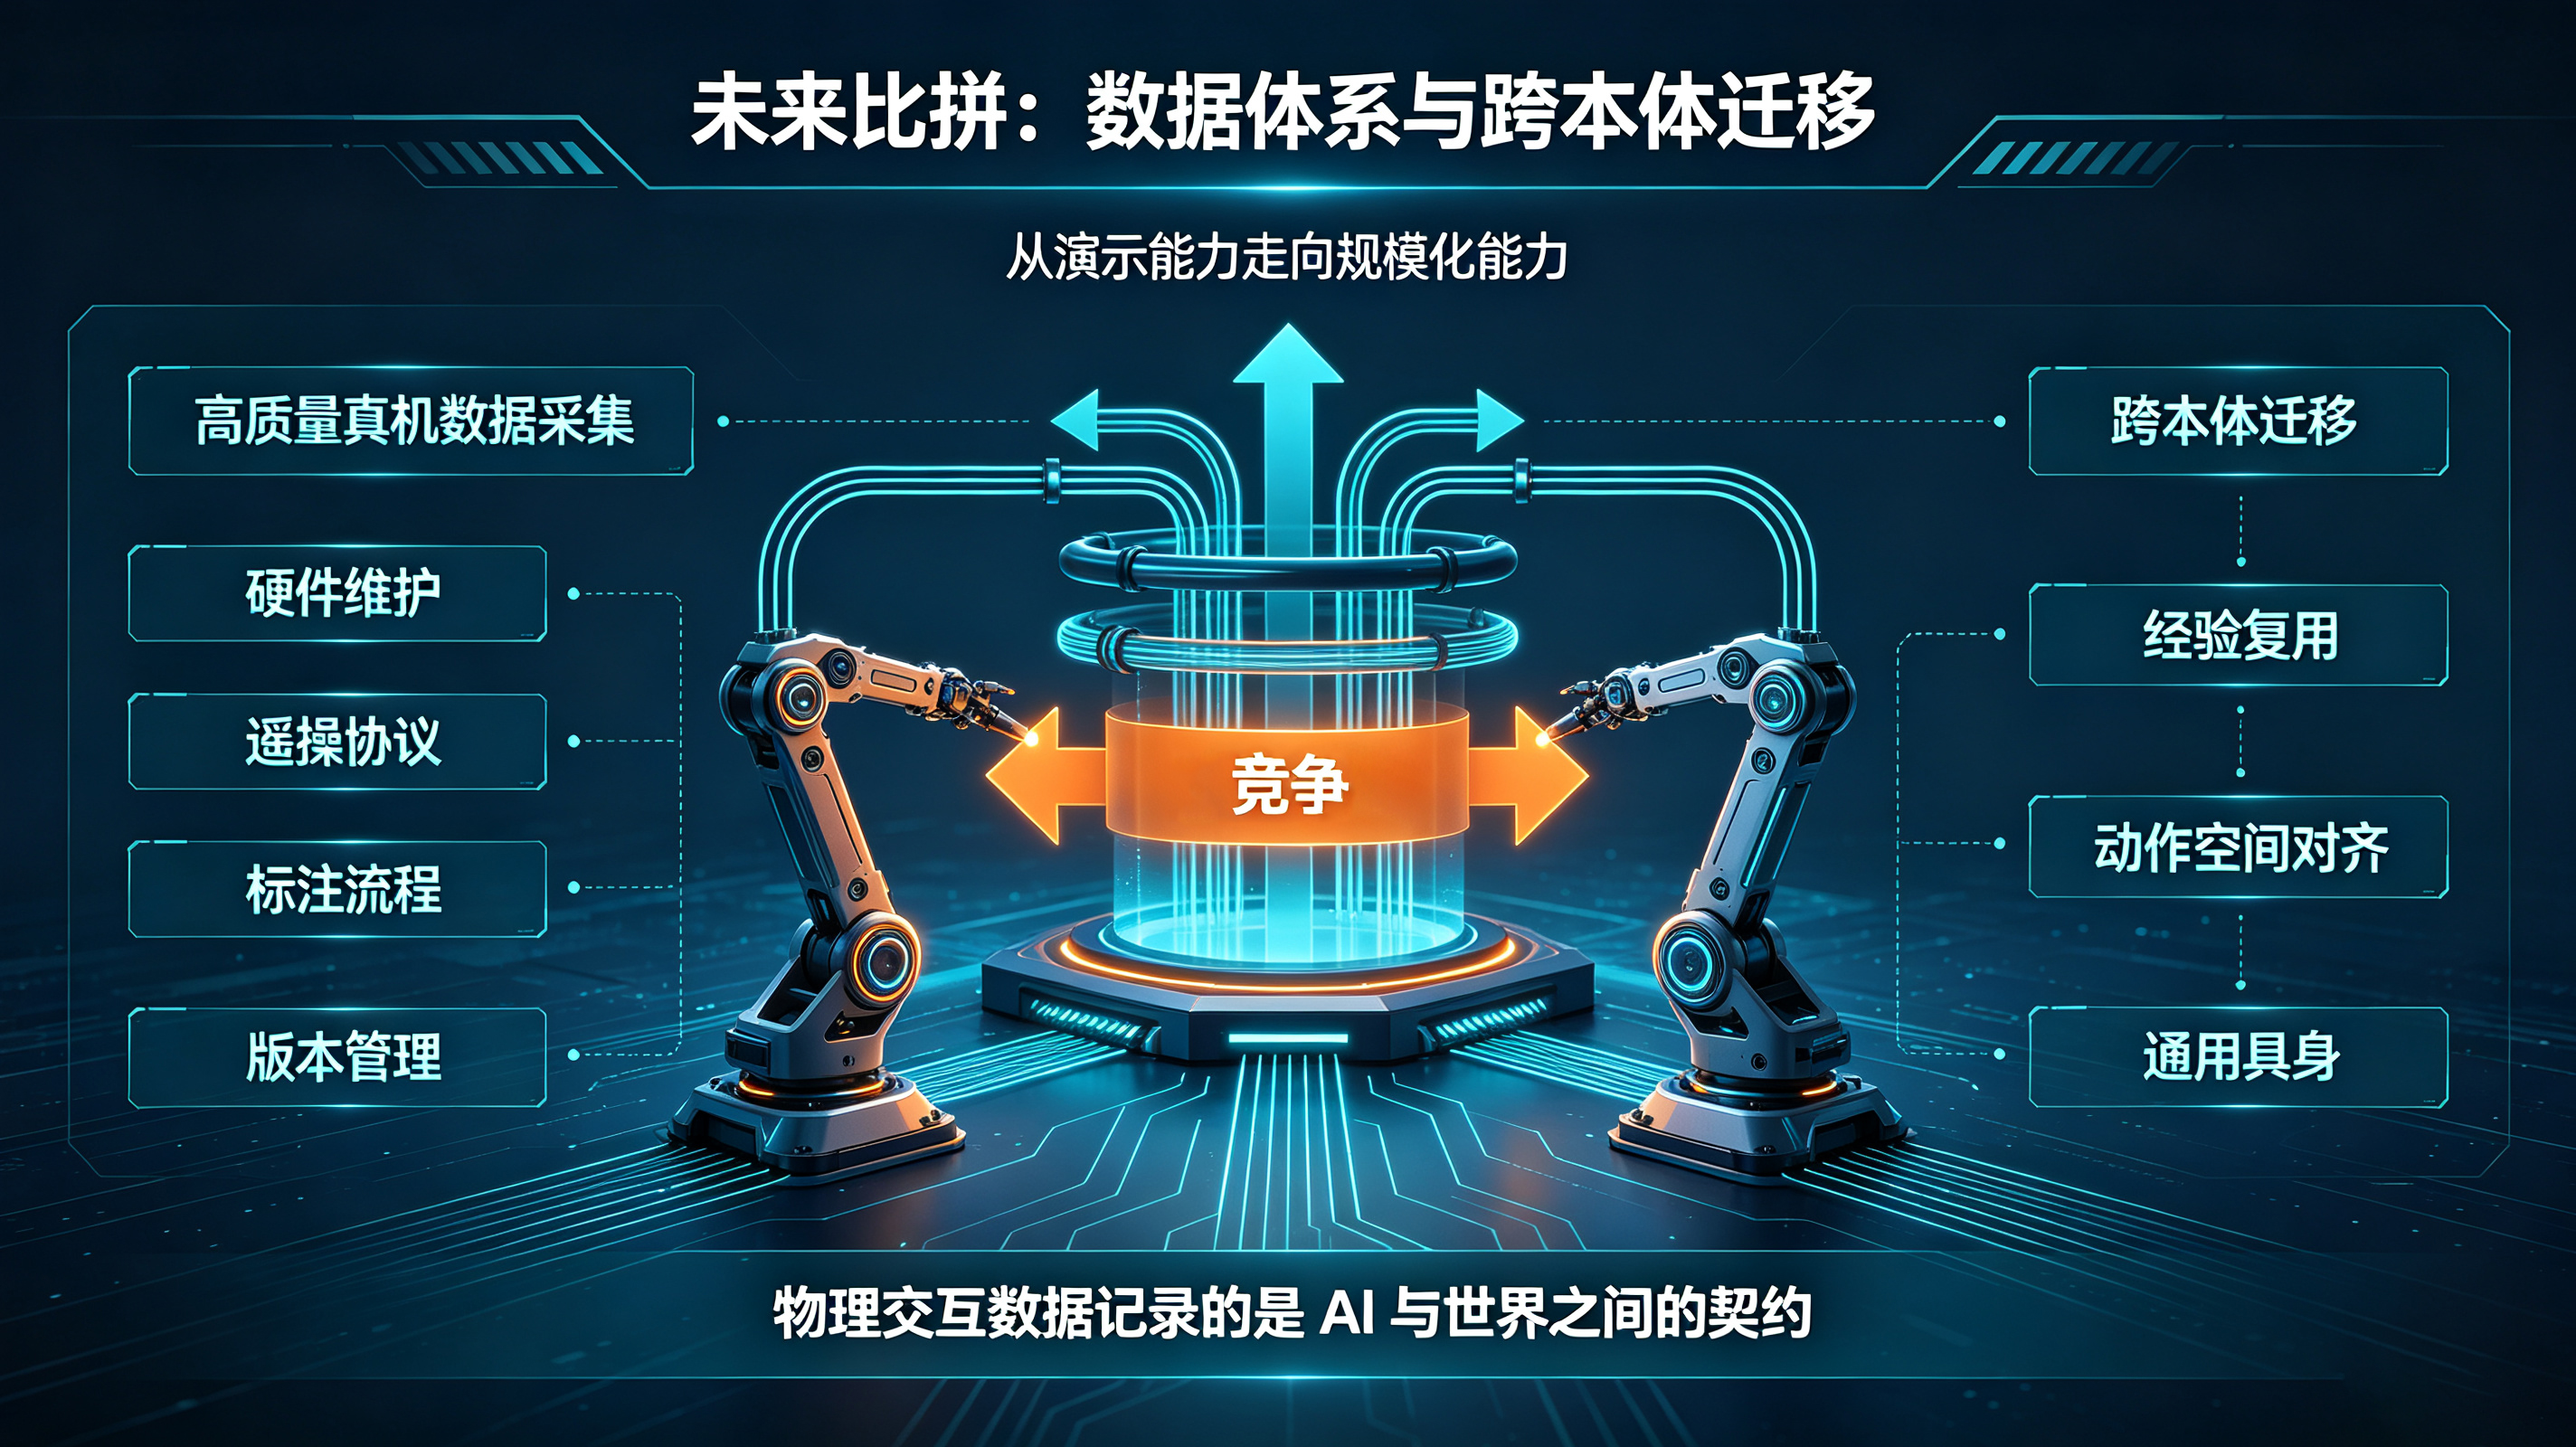
数据效率而非数据量,将决定这个领域的胜负。这意味着采集方案、标注体系、设备运维能力都会被重新评估。
背后的支撑是一整套工程体系:硬件维护、遥操协议、标注流程、版本管理。每一项都是慢功夫,但合在一起就是壁垒。
2、谁能解决跨本体的迁移
让一台机器人的经验迁移到另一台,是这个领域从"演示"走向"规模"的关键一步。谁能先把这件事做成工程常规,谁就能把数据成本大幅摊薄。
物理交互数据之所以珍贵,是因为它记录的是 AI 与世界之间的契约。这份契约没法靠文字转述,只能一次次亲手去签。