
当大模型遇上数字孪生:AI 终于有了一块"练手的沙盘"
一、为什么智能体需要沙盘
1、真实世界的试错成本太高
The cost of trial and error in the real world is too high.
强化学习的核心机制是试错,而试错需要海量失败。在语言任务里失败是免费的;在物理世界里,失败意味着设备损坏、生产中断甚至人身伤害。这就是为什么机器人学习长期受困于样本效率:真机上一天采集的轨迹,可能还不如仿真里几分钟的产出。更要命的是,设备失效、极端工况、人员误入这类危险场景,根本不可能在真实环境里刻意制造出来用于训练。
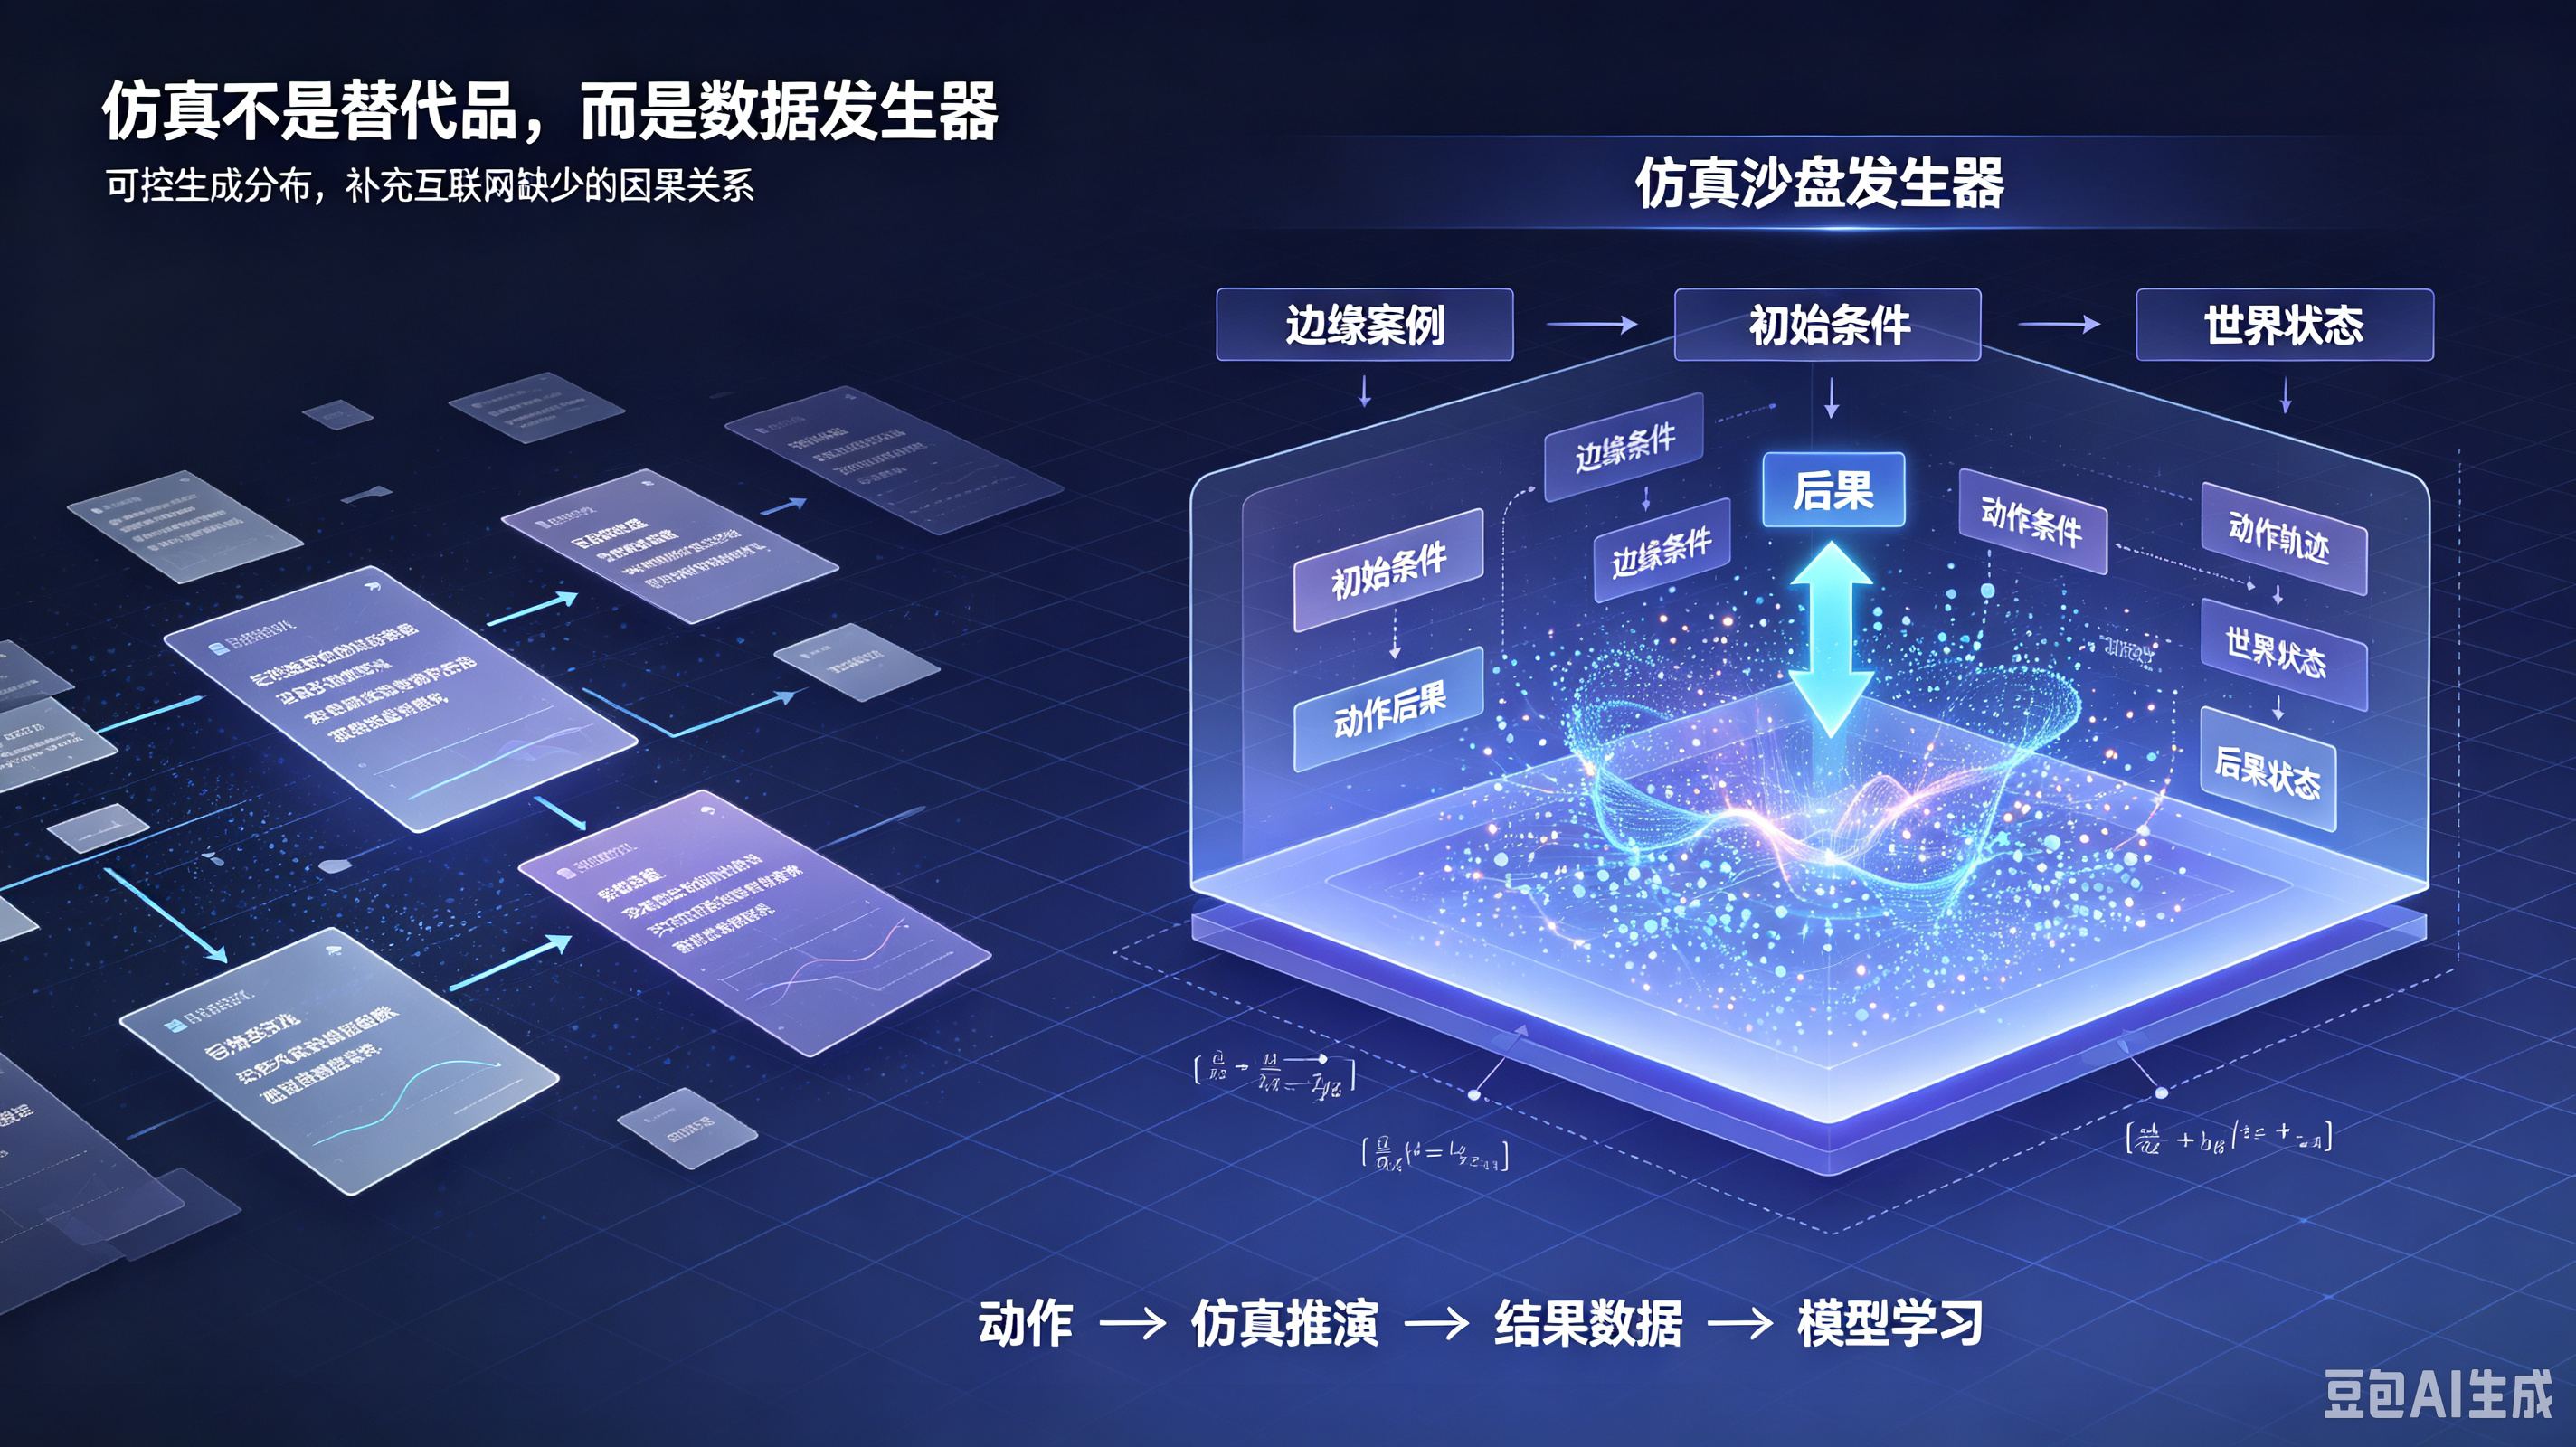
Simulation is a data generator, not just a substitute.
早期业界把仿真当成真机数据的廉价替代,效果不佳。现在的主流认知变了:仿真的真正价值是可控地生成分布——想要多少边缘案例就有多少,想要什么初始条件就设定什么初始条件。对大模型而言这一点尤其关键:互联网数据里缺少"操作"与"后果"的对应关系,而仿真恰好能补充——它知道施加某个动作之后世界会变成什么样。
二、数字孪生能提供什么
1、可控、可复现、可并行
Controllable, reproducible, parallelizable
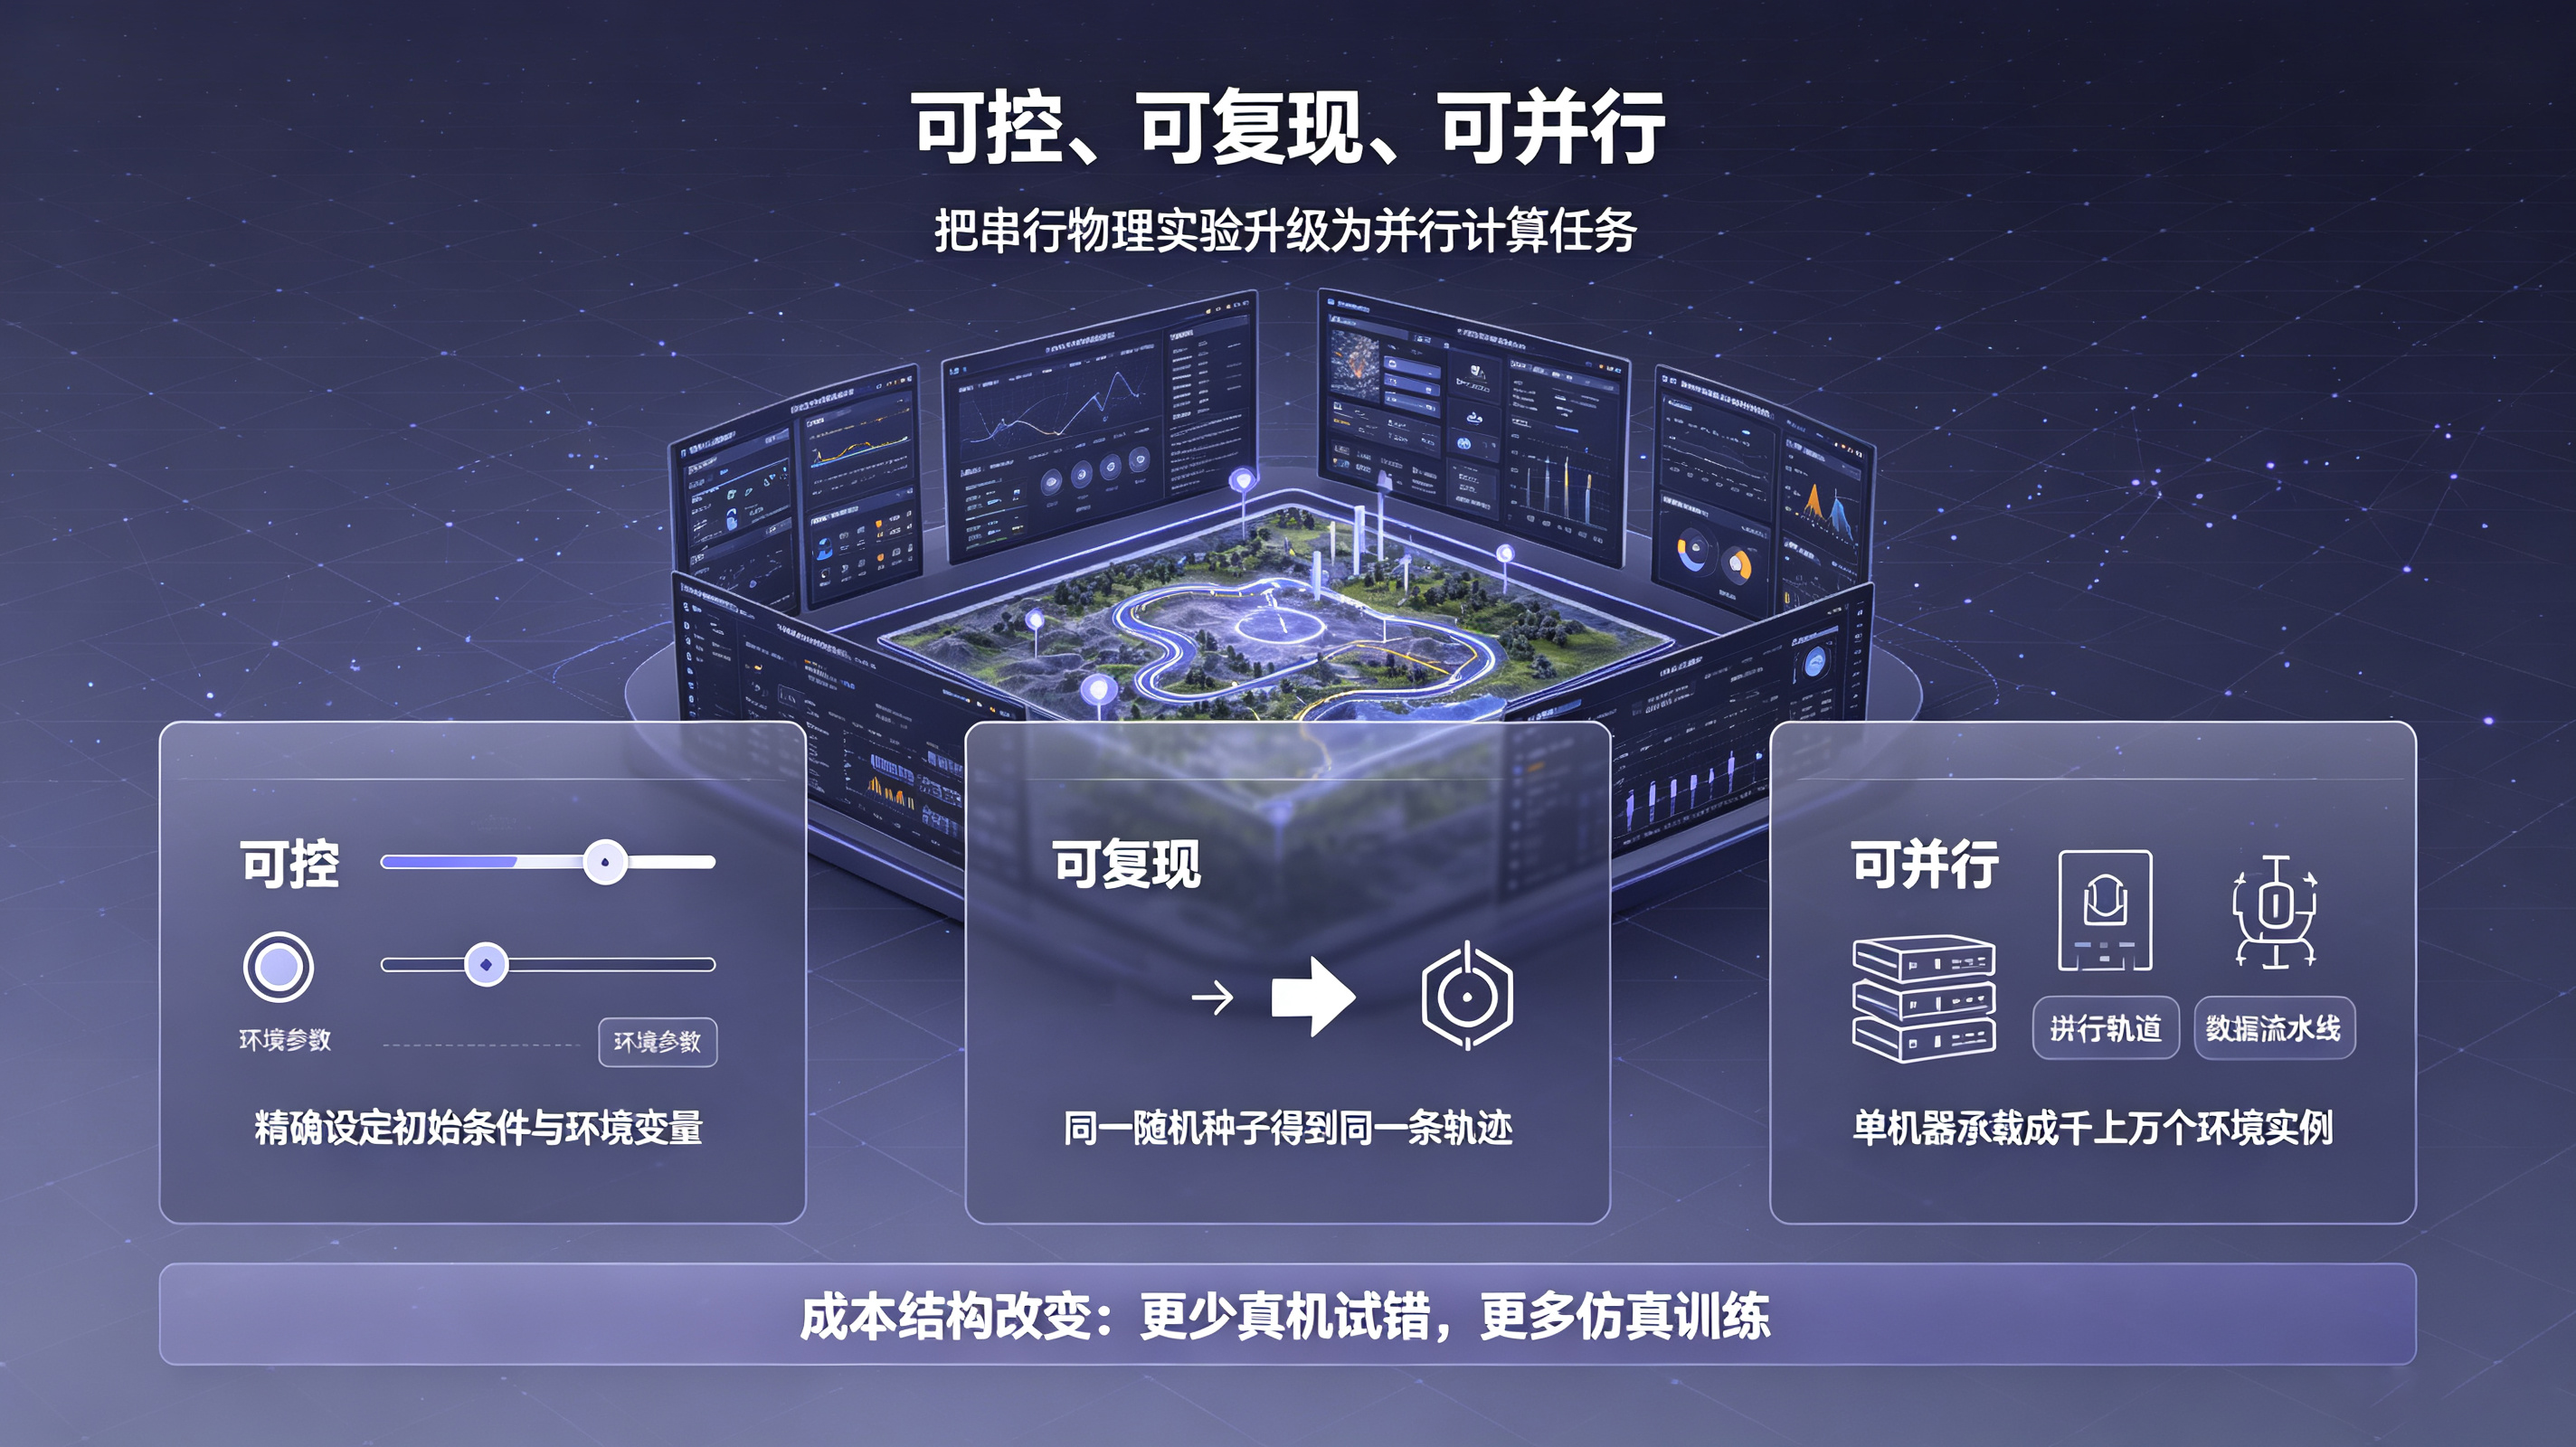
这三个特性恰好对应智能体训练的三个刚需。可控意味着可以精确设定初始条件和环境变量;可复现意味着同一个随机种子必然得到同一条轨迹,便于调试归因;可并行意味着一台机器能同时跑成千上万个环境实例。三者叠加,把数据采集从"串行物理实验"变成了"并行计算任务",成本结构发生了质变。
2、状态与物理约束是额外的礼物
States and physical constraints are extra gifts.
与纯数据驱动的世界模型不同,数字孪生内置了物理约束和领域知识:它知道传送带的速度上限、机械臂的关节极限、工艺参数的合法区间。这些约束对学习是有益的先验,把搜索空间限制在物理上可能的区域内,显著减少无意义探索。同时它还能充当安全过滤器——模型给出的动作若违反物理约束,可以直接在孪生里被拦截。
三、两者结合的三个层次
1、用孪生生成训练数据
Use twin generation to train data
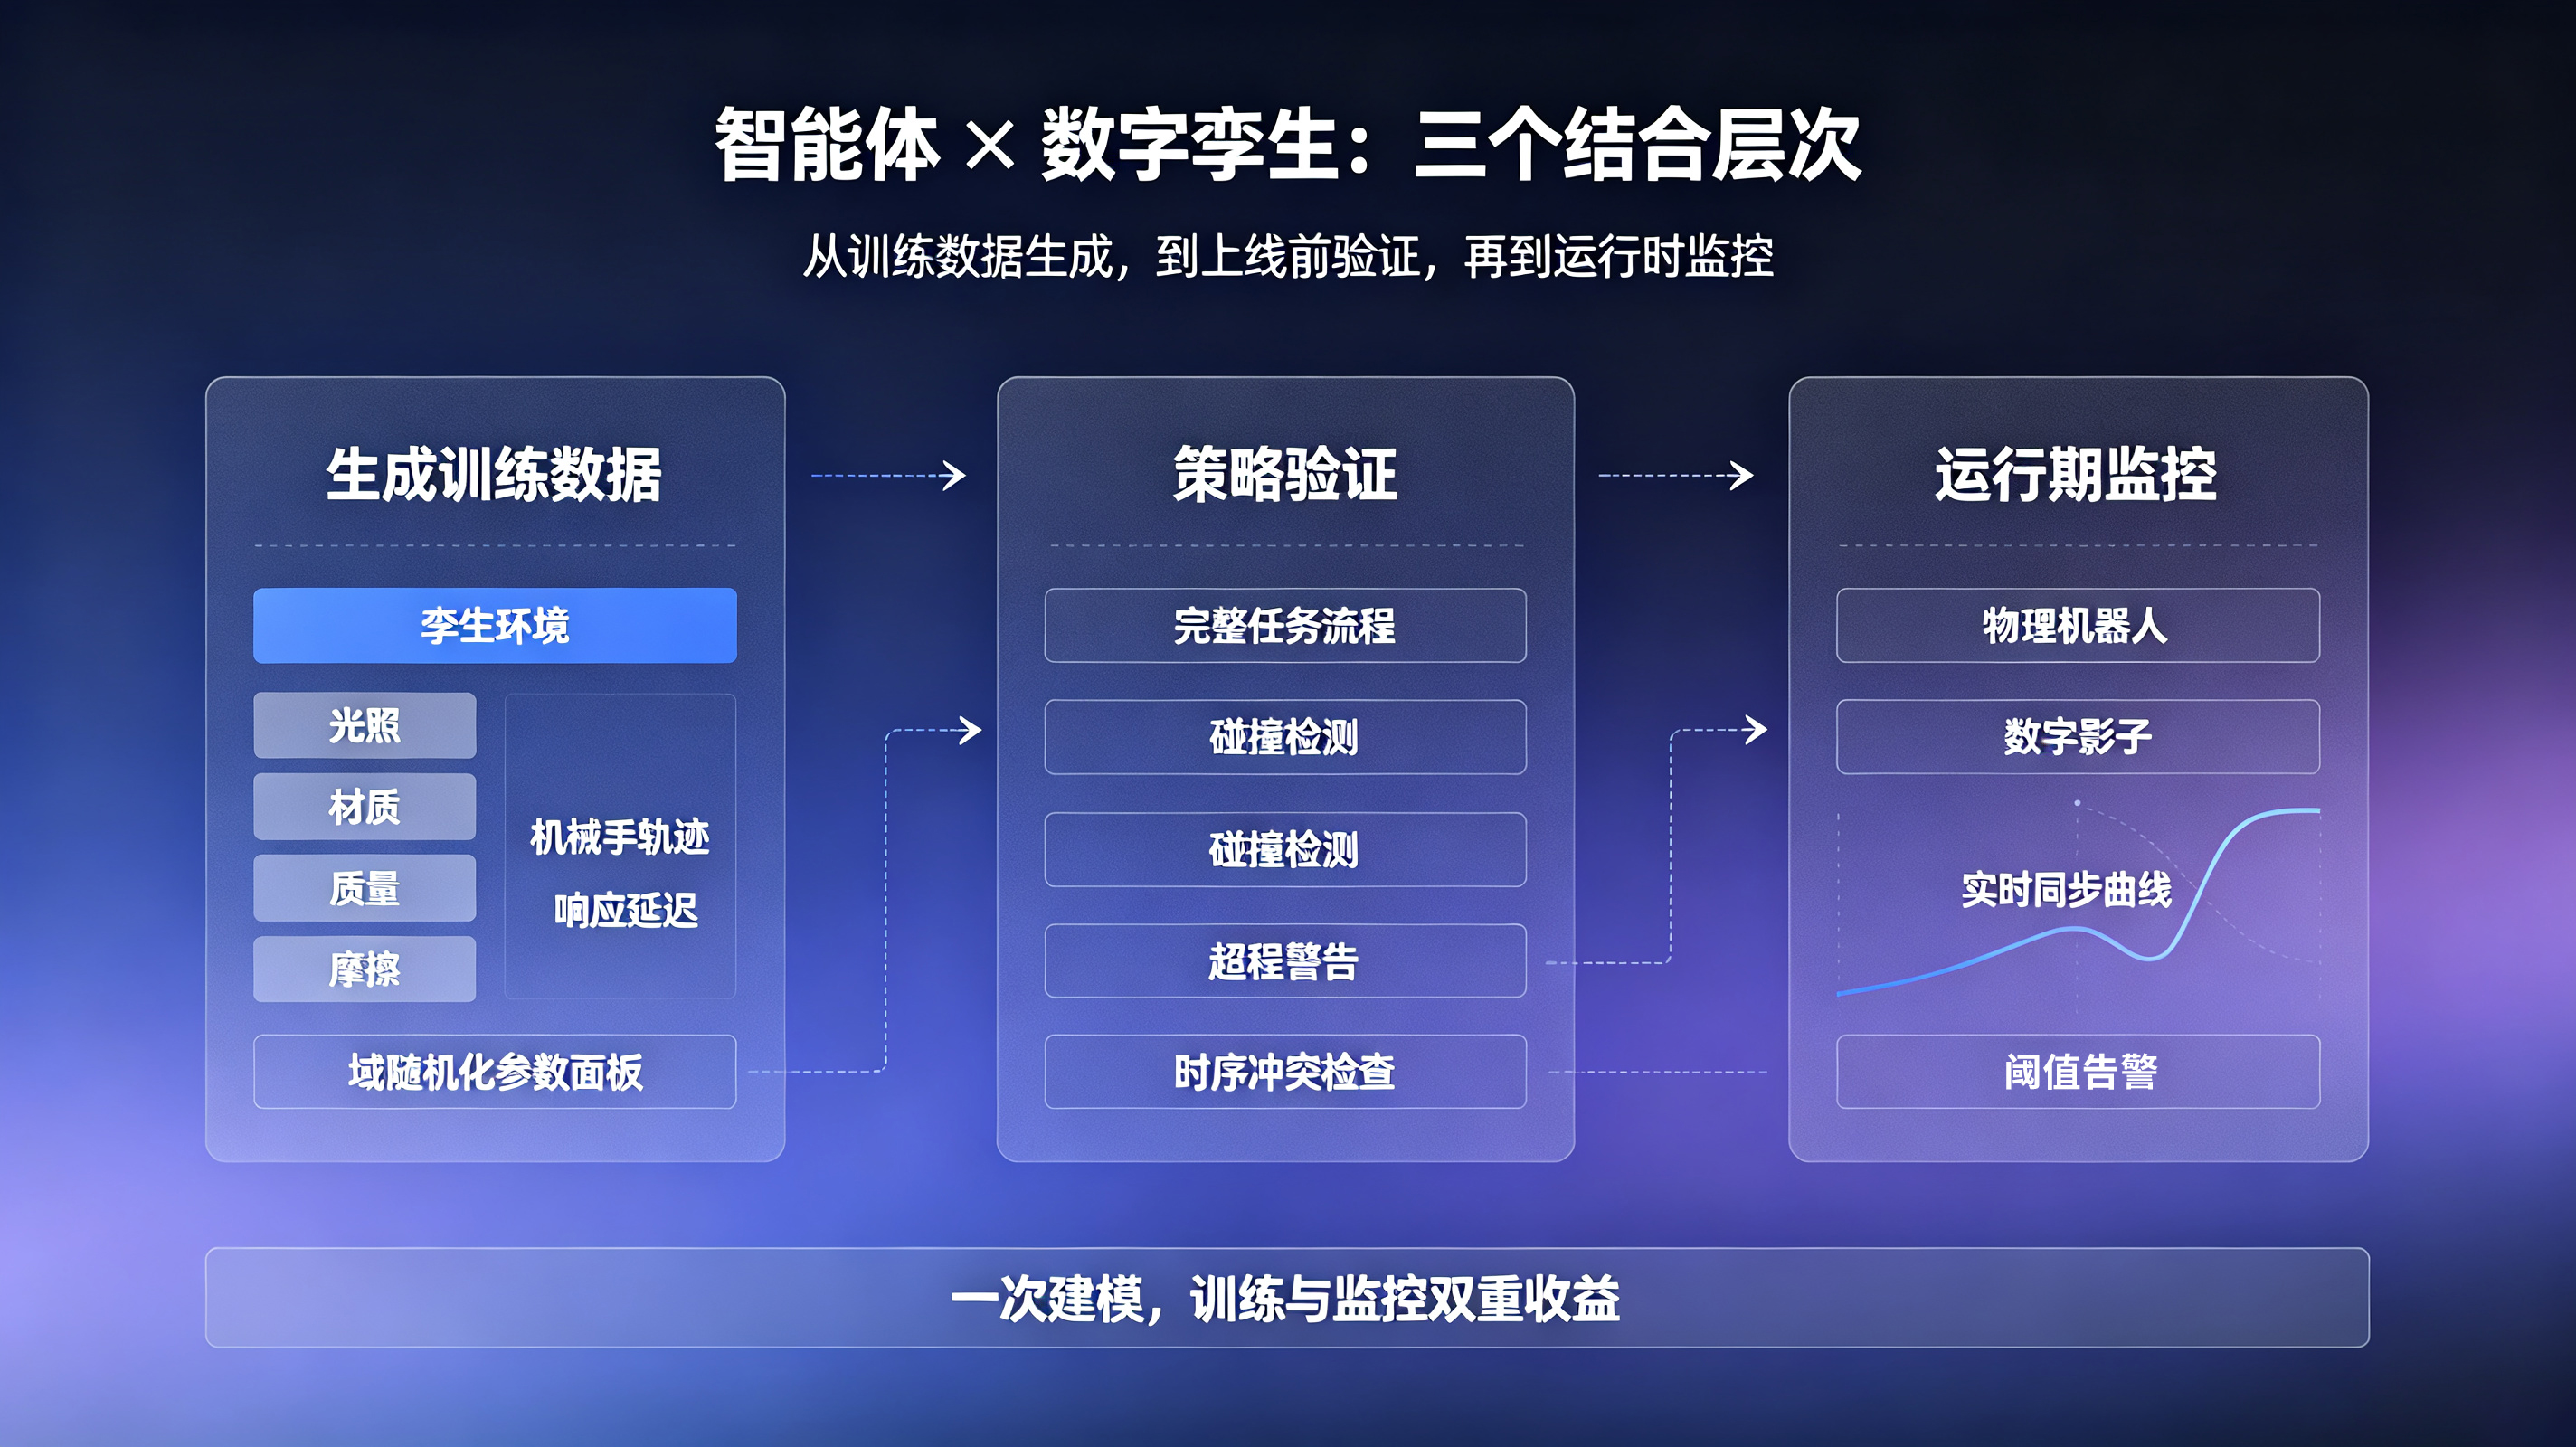
最直接的层次:在孪生环境里批量生成操作轨迹,用于预训练或数据增强,配合域随机化(随机化光照、材质、质量、摩擦、响应延迟)显著提升鲁棒性。
2、用孪生做策略验证
第二层次是上线前验证。真实机器人部署昂贵且不可逆,先在孪生里跑完整任务流程,检查碰撞、超程、时序冲突,能把大量低级错误拦截在部署之前。这与制造业里已经相当成熟的"虚拟调试"是同一套逻辑:把返工成本从物理世界前移到数字世界
3、孪生做运行期监控
Digital twin runtime monitoring
第三层次是运行时数字影子:孪生与物理系统持续同步,实时比对实际状态与模型预期,偏离超阈值即告警。这就把训练用的仿真资产复用成了运行期的监控资产——一次建模,两处收益。这也是为什么标准化定义里要把"同步"写进去。
四、工程现实:权衡无处不在
1.保真度与速度是一对矛盾
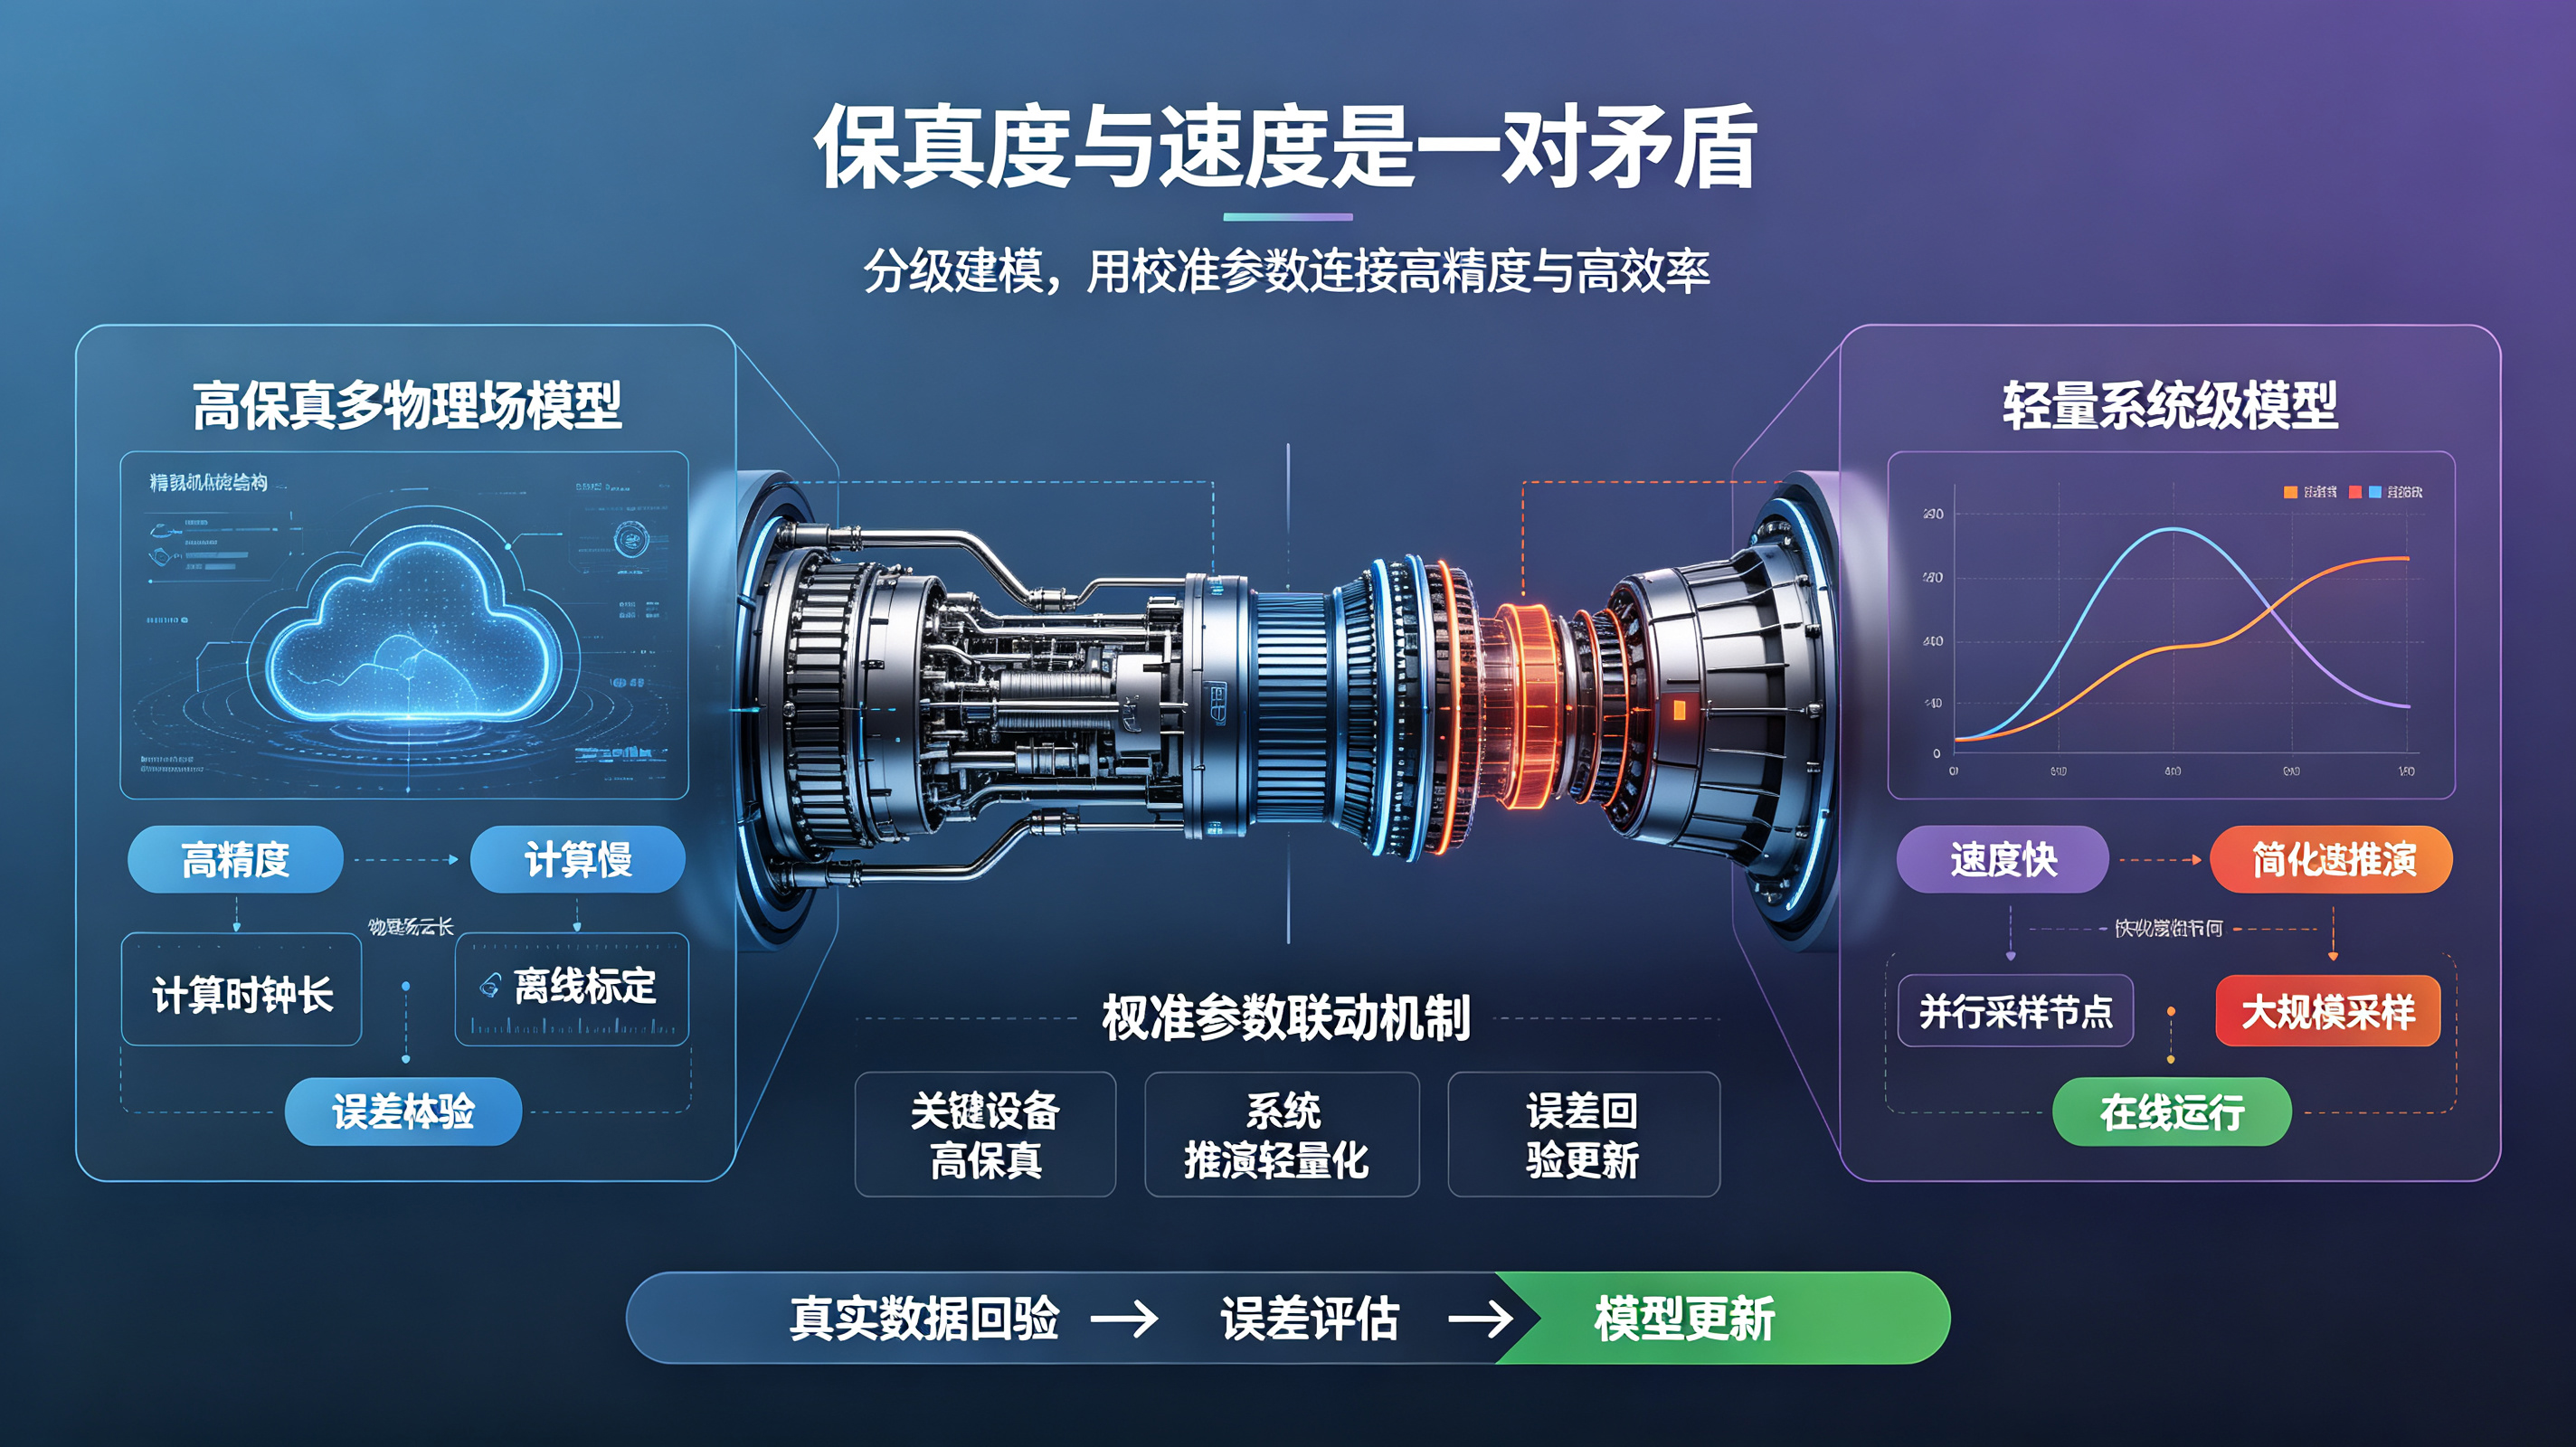
高保真多物理场仿真可能要跑几小时,无法支撑大规模采样;简化模型跑得快,结论却不可信。通行解法是分级建模:关键设备用高保真模型离线标定,系统级推演用轻量模型在线运行,两者通过校准参数联动。同时必须建立保真度评估机制——定期用实际数据回验误差,超阈值触发更新,否则模型会在几个月内悄悄失效而无人察觉。
2、从离线到在线的鸿沟
The gap from offline to online
离线训练好的策略,部署后仍会遇到分布漂移:设备老化、季节变化、工艺调整都会改变系统特性。这要求孪生不能是静态的,它需要持续接受真实数据回流并更新自身参数。这也是 ISO 23247 把"同步"写进定义的原因——没有持续同步的孪生,本质上只是一份会过期的模型文件。
五、风险与治理
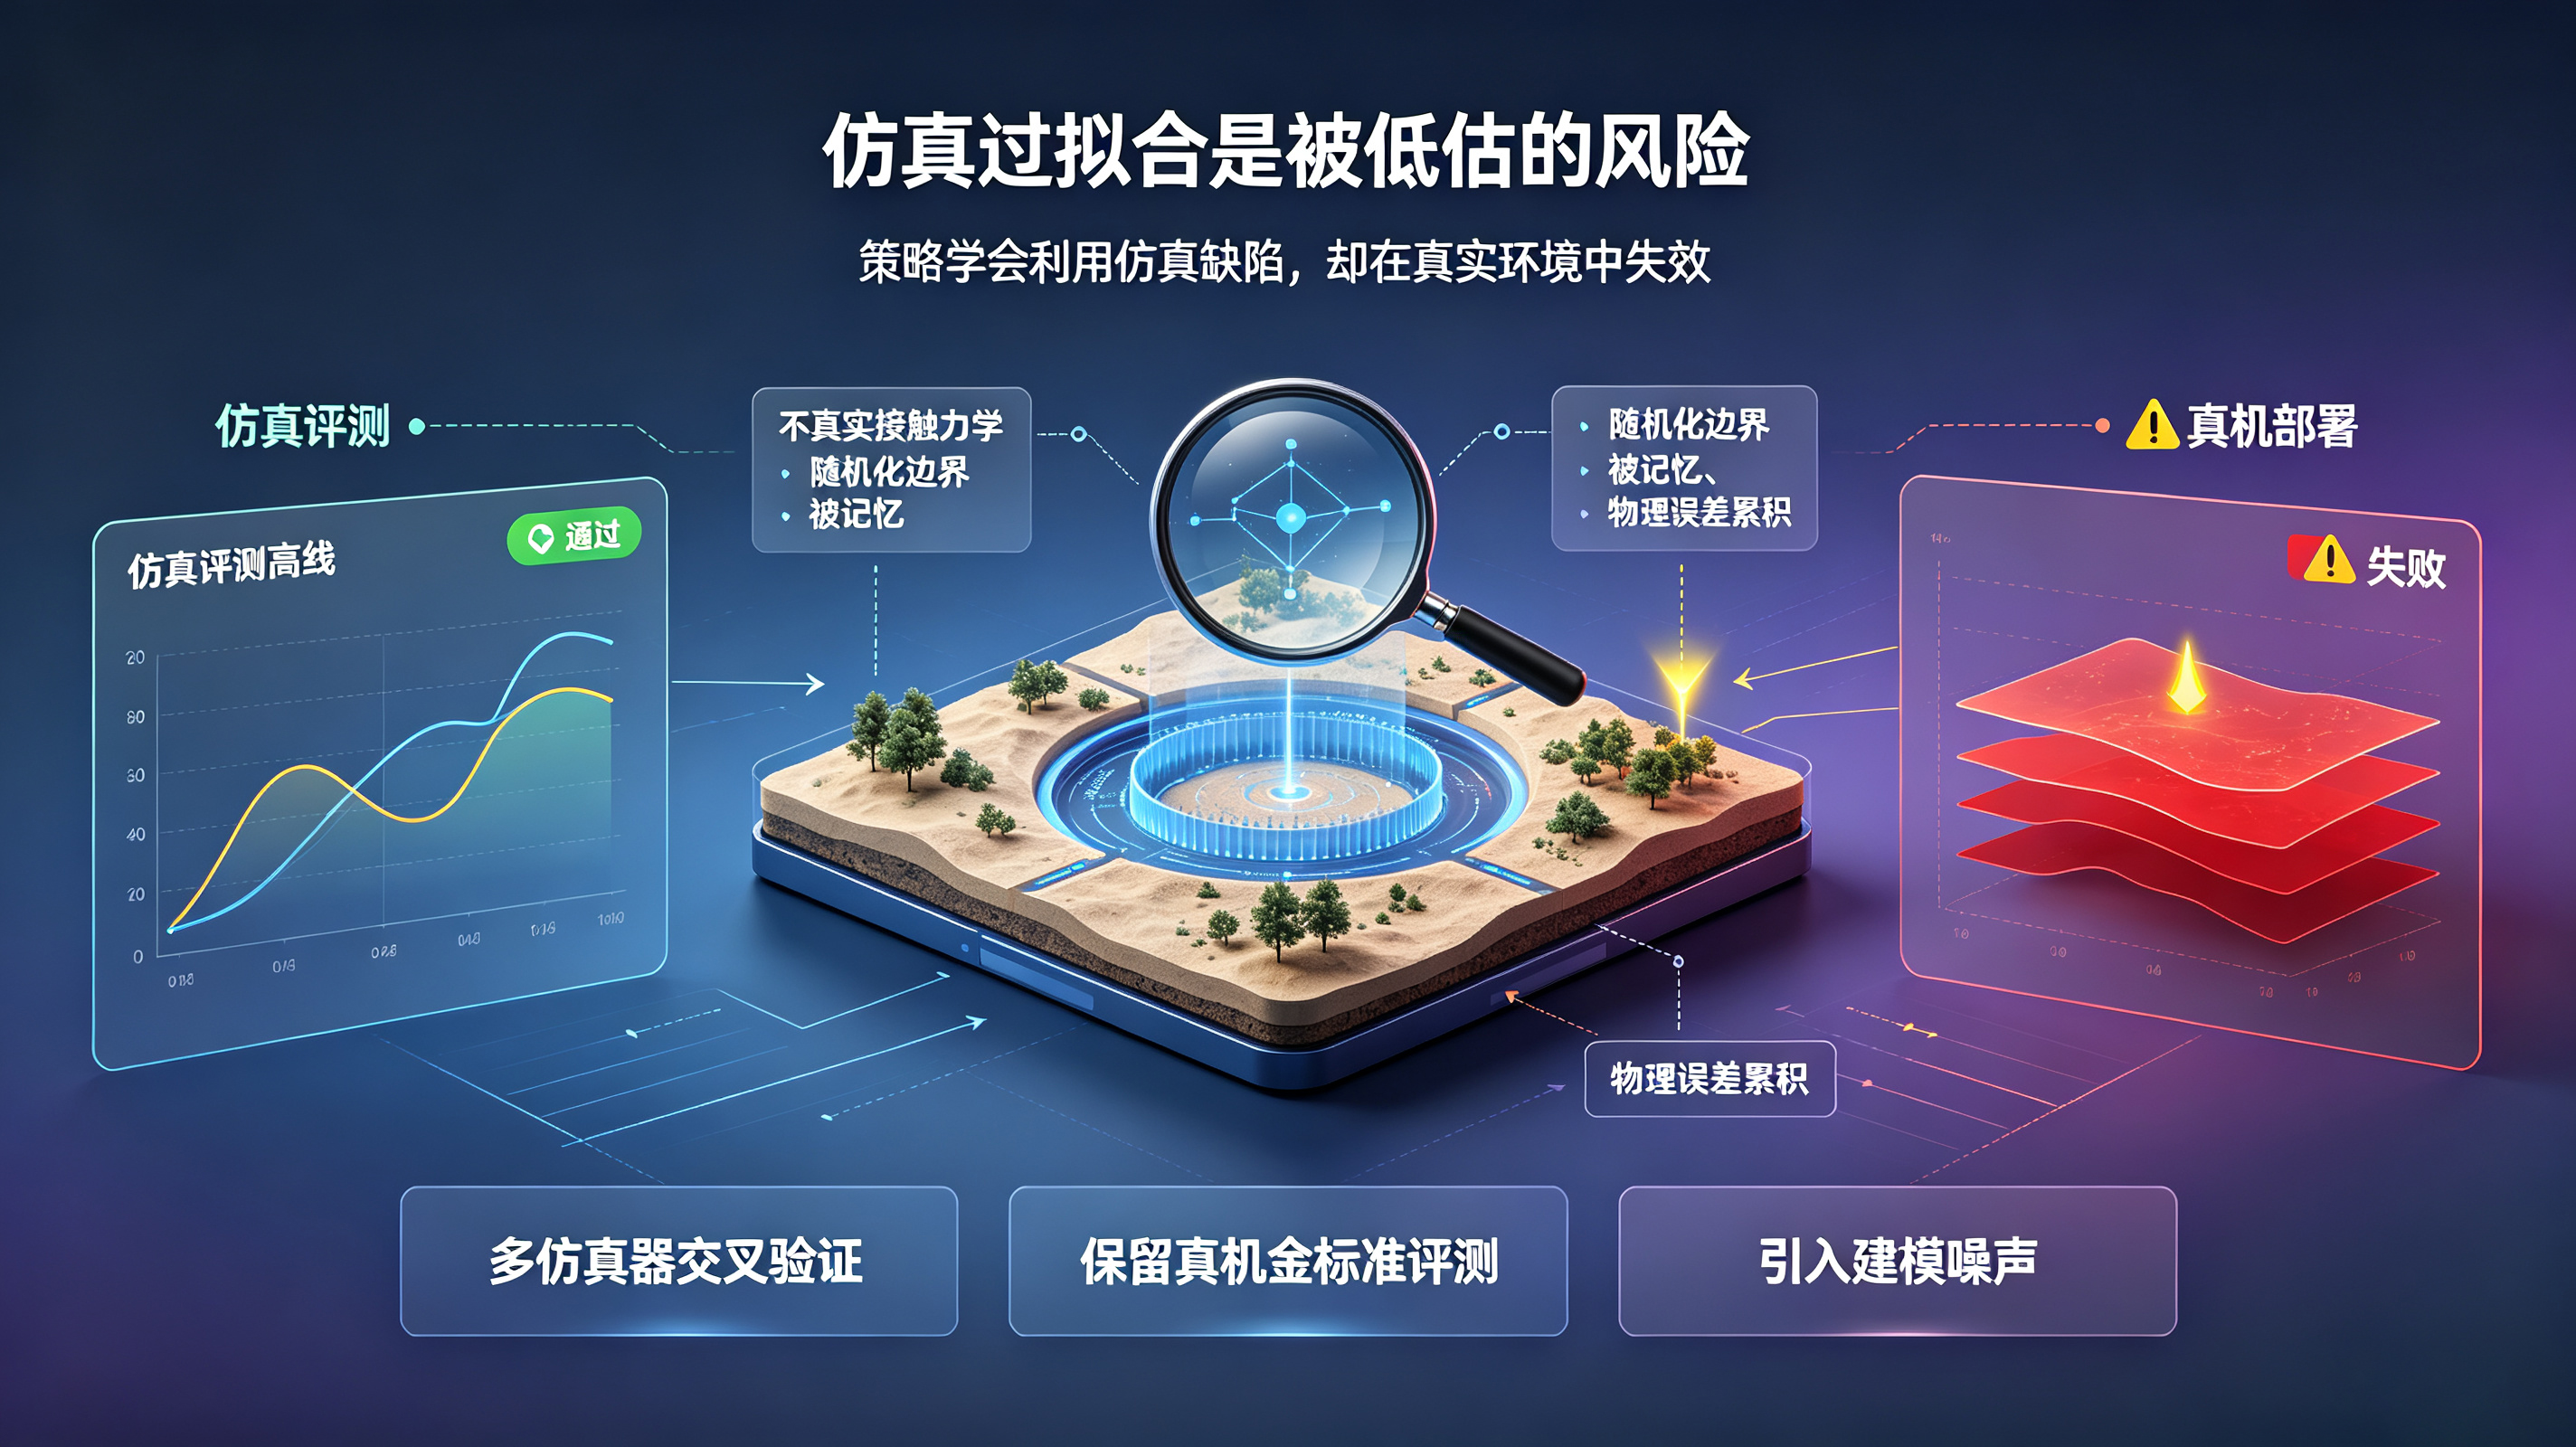
1、仿真过拟合是被低估的风险
Simulation overfitting is an underestimated risk.
策略可能在仿真里表现优异,却只学会了利用仿真器的建模缺陷——比如利用了不真实的接触力学,或记住了随机化范围的边界。这种"对仿真器过拟合"比过拟合训练集更隐蔽,因为它不容易在仿真评测中被发现。缓解手段包括多仿真器交叉验证、保留真机评测作为唯一金标准、刻意在仿真中引入建模噪声。
2、决策可解释与留痕
Decision explainability and traceability
当 AI 的决策开始作用于物理系统,追溯能力就成了刚需:为什么当时选择这个动作?依据哪些状态?模型是哪个版本?监管节奏已经明确——欧盟《人工智能法案》自 2026 年 8 月 2 日起全面执法并适用透明度义务,高风险系统义务将在 2027 年底与 2028 年分批落地。大模型负责"想",数字孪生负责"试",二者结合的本质是把试错搬回数字世界。